Tuesday, August 29, 2006

Time & Goal

Devid Seah เขาเขียนบทความ Roomba Productivity
มีอยู่ part หนึ่งที่เขาพูดถึง role of time
โดยเขาลองจับคู่ Time กับ Goal ดู
  • Time Specific/Specific Goal
    อันนี้คือสิ่งที่เราพยายามจะเป็นกัน GTD (Get Things Done)
  • Time Specific/Unspecific Goal
    อันนี้ด้านหนึ่งคือ model ที่ติดตัวมากับน้องๆที่พึ่งจบจากมหาวิทยาลัย
    ในอีกด้าน Unspecific Goal ไม่ได้หมายความไม่ได้ทำอะไร
    คนที่ทำงานจนหัวยุ่ง แต่ไม่มีเป้าชัดๆก็มี
  • Time Unspecific/Specific Goal
    ชอบสำนวนที่เขาเปรียบเปรย "It's done when it's done"
  • Time Unspecific/Unspecific Goal
    อันนี้สิที่น่าสนใจ
    ในตอนแรกที่อ่าน ก็คิดว่าอันนี้มันต้องเป็นพวกไม่เอาไหนแน่ๆ
    แต่มันมีอีกมุมแฮะ ลองไปอ่านตัวอย่างของเขาดูแล้วกัน

Related link from Roti

Monday, August 28, 2006

กีฬา, การจัดการ

วันนี้นั่งค้นข้อมูลงานกีฬายุวชนโลกที่จัดในช่วงนี้
ตั้งใจว่าจะพาลูกชายไปดูพี่ๆเขาเล่นกีฬาสักหน่อย
กว่าจะหาตารางเวลาการแข่งขันเจอนี่ ใช้เวลาอยู่นานเชียว

ส่วนใหญ่ข้อมูลที่ได้จากหนังสือพิมพ์ต่างๆ ก็คือ
งานนี้เป็นงานอะไร ใครเป็นเจ้าภาพ จัดช่วงวันที่นี้ถึงนี้นะ
ไม่ได้ให้ข้อมูลอะไรมากไปกว่านี้
พอเจอ web site หลักของงาน ก็เจอปัญหาว่า
คนออกแบบคงไม่ได้ตั้งใจออกแบบมาให้คนที่สนใจที่จะไปชมใช้
กว่าจะปะติดปะต่อข้อมูลได้ ก็ต้อง click เข้าไปหลายๆจุดหน่อย
(แถมยังต้องผ่านด่าน flash ที่น่ารำคาญในหน้าแรกเข้าไปด้วย)

เห็นความสะเปะสะปะของข้อมูล และหน้า web site แล้ว
ก็นึกถึงประสบการณ์ที่มีโอกาสได้ไปยุ่งเกี่ยวกับการจัดการแข่งขันไตรกีฬาที่นครพนม
ตอนนั้นรุ่นพี่คนหนึ่งเขามาชวนให้ผมไปเที่ยว
แล้วก็เป็น staff ในส่วนของการดูแลความปลอดภัยทางน้ำ
ก็เลยแบกถังดำน้ำ กับอุปกรณ์ดำน้ำไปจากกรุงเทพฯกัน

พอไปถึง รุ่นพี่ที่ไปด้วยเห็นคนจัดเขายุ่งๆ แล้วก็ไม่ค่อยพร้อม ก็เลยบอกไปว่า
ผมทำงานด้าน computer ,สามารถช่วยเหลือในด้านนี้ได้นะ
ไอ้เราไม่ทันตั้งเนื้อตั้งตัว ขี้เห็นใจ + ไม่ชอบปฎิเสธคน
ก็เลยได้แถมเป็นผู้ดูแลการรวมรวมและประมวลผลเวลา อีกตำแหน่ง

วันแข่งจริง พอเห็นเรือนี่เริ่มขมวดคิ้วเลย
เรือที่จัดให้เป็นเรือหางยาว ความคล่องตัวไม่ต้องพูดถึง
น้อย ถึงน้อยที่สุด
ยังดีที่มีทั้งทหารบกและทหารเรือมาช่วยเสริมก็เลยอุ่นใจขึ้น
ทหารบกที่มา เป็นกลุ่มที่ทำธุรกิจเรื่องเรือ canoe อยู่
มีเรือ canoe มาหลายลำเชียว พวกนี้ความคล่องตัวจะสูง
แถมยังบังเอิญเป็นพี่ที่เคยรู้จักกันสมัยผมไปเล่นเรือ canoe ที่นครนายกด้วย
(ผมยังเคยไปเป็น staff เรือแคนนูให้กลุ่ม ป๊อบ อารียา ด้วยนะ
หน้าที่ก็คือ ดูว่าเรือลำไหนล่ม ช่วยคนแล้วก็กู้เรือมาให้เขาเล่นต่อ)
ส่วนทหารเรือ ก็มีเรือยางซึ่งเหมาะกับการช่วยเหลือทางน้ำอย่างมาก

แค่จะเริ่มแข่งก็สนุกแล้ว
พวกการเมืองท้องถิ่น ก็เข้ามายุ่ง อยากให้ลาวเขามีเอี่ยวด้วย
ก็เลยไปเริ่ม start ที่ฝั่งลาวกัน
พอเสียงปืนดังปัง นักกีฬากระโดดน้ำ
ปัญหาแรกก็คือ แม่น้ำโขงมันไหลแรงมาก
นักกีฬา 200-300 คน ก็เลยแตกกระจายออกไปทั่วเลย
ผมนี่เครียดเลย มันจะดูทันได้ไงวะ กระจัดกระจายกันขนาดนี้

ผลของน้ำที่แรงมาก ทำให้นักกีฬาที่ว่ายน้ำกลางๆ,ว่ายน้ำไม่เก่ง
หรือว่ายเก่งแต่ไม่มีประสบการณ์ว่ายในน้ำเชี่ยว
ไหลเลยทุ่นลูกแรกไปเกือบหมด
พวกที่รู้ตัว ก็ไม่ฝืน ลัดเข้าทุ่นถัดไป
ส่วนพวกที่เคารพกฎก็เลยอยู่ในสถาพที่ว่ายทวนน้ำเข้าหาทุ่น
ด้วยความแรงของน้ำขนาดนั้น สภาพก็เลยเป็นการว่ายอยู่กับที่
หลังจากดูอาการแล้ว จะว่ายอีกกี่ชั่วโมง ก็ไม่มีทางไปถึงแน่
ผมก็ให้เรือเข้าเทียบแล้วก็สั่งให้ว่ายลัดทีละคน
มีฝรั่งบางคนจะดื้อไม่ยอมฟัง
ก็เลยต้องขึ้นเสียง บอกว่าผมเป็นกรรมการนะ
ผมขอสั่งให้คุณว่ายลัดไปที่ทุ่นนั่นเดี๋ยวนี้
(จริงๆแล้วเราไม่ใช่กรรมการหรอก)

พอจัดการกลุ่มที่มีปัญหาเสร็จ ดูแล้วผ่านหมดแน่ ก็ให้เรือเทียบฝั่ง
วิ่ง 300 เมตรปีนตลิ่งขึ้นมาดูเรื่อง computer ต่อ
(นึกแล้วตลก, ที่ไปช่วยนี่เงินก็ไม่ได้
แต่ตอนนั้นวิญญาญความรับผิดชอบมันสิงแล้ว)

ปัญหาของการรวมรวมเวลามีสองเรื่องก็คือ
1. format ของข้อมูลที่เข้ามาไม่เหมาะกับการประมวลผล
(จริงๆมันง่ายนะ ถ้ารู้ว่าต้องการ output อะไร
แต่ปัญหาก็คือ ก่อนหน้านี้ไม่มีคนดูแล)
2. ช้อมูลต้องถูกต้อง ห้ามป้อนผิด

นั่งทำจนบ่ายสองบ่ายสามแล้วก็ยังไม่เสร็จ
(เริ่มแข่งตอนเช้า)
ตอนนี้แหล่ะที่ทำให้ได้สัมผัสนักช่าวจากไทยรัฐ
เริ่มจากพวกเด็กๆมาก่อน
บอกจะรีบส่งข่าว เดี๋ยวไม่ทันปิดต้นฉบับ
เราก็บอกยังไม่เสร็จ ถ้าเสร็จแล้วจะให้
สักพัก ก็มีตัวใหญ่มา
เราก็พูดเหมือนเดิม เสร็จแล้วจะให้
พี่แกยืนไม่ยอมไปไหน
แต่ผมก็ไม่สนใจ นั่งตรวจข้อมูลต่อ
สักพักก็พูด
"คุณรู้เปล่าว่าผมเป็นใคร"
"ผมเขียนข่าวหน้า 4 ของไทยรัฐ"
"ขอรายงานผลเวลาด้วย"
ผมนี่ฉุนกึกเลย ก็เลยมองหน้ายักไหล่ แล้วก็บอกสั้นๆ
"แล้วไง, ผมไม่สนว่าคุณเป็นใครหรอก, ออกไปได้แล้ว"

วกเข้าเรื่องดีกว่า (ชักจะออกนอกเรื่องแล้ว)
ที่ตั้งใจจะบอกก็คือ การจัดการในบ้านเรานี่มันแย่จริงๆ
ไม่ว่าจะเรื่องกีฬาหรือเรื่อง IT (จริงๆแล้วทุกเรื่องนั่นแหล่ะ)

Related link from Roti

Thursday, August 24, 2006

Amazon EC2

Amazon EC2 เป็นบริการใหม่ของ Amazon
ทำให้เราสามารถ สร้าง Amazon Machine Image (AMI) ที่ต้องการ
(จริงๆแล้ว มันก็คือ disk image ที่เอาไปใช้ run virtual machine)
นำไป deploy บน Amazon EC2
จากนั้นก็สามารถ start instance ตามจำนวนที่ต้องการได้

ลองดูตัวอย่างสถานะการณ์การใช้งาน
Mary wishes to deploy her public, fault tolerant, three tier web service in Amazon EC2. Her grand plan is to have her web tier start off executing in seven instances of ami-fba54092, her application tier executing in twenty instances of ami-e3a5408a, and her multi-master database in two instances of ami-f1a54098.


ค่าบริการคิดตามที่ใช้จริง
processing - $0.10 per instance-hour
data transfer (internet traffic) - $0.20 per GB
Storage - $0.15 per GB
(storage ใช้บริการจาก Amazon S3)

วิธีที่สร้าง AMI (Amazon Machine Image) ก็คล้ายๆกับที่เรา add guest-os ให้กับ xen
โดยต้องทำในเครื่องเราให้เรียบร้อยก่อน
จากนั้นจึง upload ขึ้นไป

ดูจากวิธีการสร้าง image แล้ว
ตัว infrastructure ของ EC คงใช้ fedora กับ xen

ข้อจำกัดอีกอย่างก็คือ
ตัว server ต้องใช้ dynamic IP เท่านั้น

ข้อดีที่เห็นชัดๆ ก็คือ เราสามารถเพิ่ม instance ได้ตามต้องการ
ทำให้การตอบสนองต่อพวก spike load ทำได้โดยง่าย

อย่างนี้ A-NET, O-NET ก็น่าไปใช้บริการนะ
เพราะปีหนึ่งมีประกาศผลแค่ไม่กี่ครั้ง แต่ต้องลงทุน server ไปกับ spike load

Related link from Roti

Functional test with Selenium RC

ลองใช้ Selenium มาทั้ง 3 แบบแล้ว
core, firefox extension, remote-control
สุดท้ายก็ชอบแบบ remote-control มากที่สุด
โดยเฉพาะการใช้ร่วมกับ ruby

ภาพรวมการทำงานของ Selenium remote-control ก็คือ
เราจะ start selenium server ขึ้นมาตัวหนึ่ง
เวลาจะ test เราก็จะเขียน program เพื่อส่ง command ที่ต้องการ test
ไปยัง server, โดย server จะสื่อสารและสั่งงานให้ browser ทำตาม command ที่เราสั่ง


ที่นี้ลองมาดูการทำงานภายในของ Selenium ดูบ้าง
วิธีการที่ selenium ใช้ควบคุม browser ก็คือการใช้ javascript
เช่นสมมติว่าเราต้องการให้เกิดการ click ที่ปุ่มๆหนึ่ง

<a href="xxxx" id="myButton">click me</a>

ในแง่ของ test script เราก็จะส่งคำสั่งต่อไปนี้

cmd = "click"
param1 = "id=myButton"

ทีนี้ selenium จะทำอย่างไร ปุ่มนี้จึงจะ click ได้
ขั้นที่ 1 ก็คือหา element ที่ต้องการ click ให้เจอก่อน
โดยวิธีการหา จะขึ้นอยู่กับ prefix ที่เรากำหนดไปใน parameter
เช่นถ้ากำหนด id= นำหน้า, selenium ก็จะใช้วิธี getElementById
แต่ถ้าเป็นพวก xpath=//img[@alt='The image alt text'] ก็จะใช้ xpath
หรือถ้านำหน้าด้วย css= ก็จะใช้ css selector ในการหา

ขั้นที่ 2 ก็คือเมื่อเจอ element ที่ต้องการแล้ว ก็ต้องทำให้เกิดการ click ขึ้นมา
ลองดูตัวอย่างของการ simulate mouse click ใน Firefox ดู
MozillaPageBot.prototype.clickElement = function(element, clientX, clientY) {

triggerEvent(element, 'focus', false);

// Add an event listener that detects if the default action has been prevented.
// (This is caused by a javascript onclick handler returning false)
var preventDefault = false;

...

// Trigger the click event.
triggerMouseEvent(element, 'click', true, clientX, clientY);

...

if (this.windowClosed()) {
return;
}

triggerEvent(element, 'blur', false);
};

จะเห็นว่า มันทำการ simulate event focus จากนั้นก็ทำการสร้าง event mouse click
สุดท้ายก็ส่ง event blur
ส่วนการทำงานภายในของ function triggerMouseEvent
ถ้าเป็น mozilla ดูเหมือนจะใช้วิธีนี้
var evt = document.createEvent('MouseEvents');
.. // init event
element.dispatchEvent(evt);

จะเห็นได้ว่า วิธีการทำงานนั้นน่าสนใจทีเดียว

ประเด็นที่ตามมาของการใช้ javascript control ก็คือ
javascript นั้นจะ run ใน domain name ที่เราต้องการ test อย่างไร
เนื่องจาก javascript จะทำงานได้กับ domain name ที่เรา load javascript นั้นมาเท่ากัน
Selenium เลยใช้วิธีการ start proxy server ขึ้นมา
เพื่อบังคับให้ request ของ browser วิ่งผ่านมันก่อน
เพื่อที่มันจะได้ inject javascript ที่ต้องการลงไปได้


หันไปดูด้านผู้ใช้ดูบ้าง
ลองดูตัวอย่าง ruby code ที่ผมเขียน test

def setup
@domain = 'http://wcfweb.test:8080'
@sel = Selenium::SeleneseInterpreter.new("selenium.server.test", 4444,
"*firefox", @domain, 15000)
@sel.start
@home = "#{@domain}/fin/app?page=wcf2000/Wcf2110_1&service=page"
end

def submit_cheque(no, date, bank, amount)
to_page2
@sel.click("link=0.00")
type_cheque(no, date, bank, amount)
calc_charge
@sel.click("save_btn")
@sel.wait_for_page_to_load(15000)
end

def t_cheque_amount_entry_but_no_other_info
submit_cheque("", "", "", 2000)
assert(@sel.is_text_present("กรุณาระบุเลขที่เช็ค"))
assert(@sel.is_text_present("กรุณาระบุวันที่เช็ค"))
assert(@sel.is_text_present("กรุณาระบุรหัสธนาคาร"))
end

def t_cheque_entry_wrong_date
submit_cheque("1234567", nextDay(2), "", 2000)
assert(@sel.is_text_present("วันที่เช็ครับลงล่วงหน้ามากกว่า 1 วัน"))
end

def t_cheque_entry_wrong_bank_code
submit_cheque("1234567", nextDay(1), 1234, 2000)
assert(! @sel.is_text_present("วันที่เช็ครับลงล่วงหน้ามากกว่า 1 วัน"))
assert(@sel.is_text_present("รหัสธนาคารไม่ถูกต้อง"))
end


เวลา run, Selenium ก็จะเปิด browser ทำงาน
โดย browser มีหน้าตาแบบนี้

Related link from Roti

Wednesday, August 23, 2006

Dojo Render Time

ช่วงแรกๆที่ใช้ Dojo จะยังไม่เจอปัญหาเรื่อง Render Time.
แต่พอในหน้าจอเริ่มมี element มากขึ้น
เวลาที่ใช้ในการ render หน้าจอ จะเริ่มช้าลงอย่างเห็นได้ชัด

ปัญหาก็คือ
เวลาเราใช้ dojo เรามักจะใช้ในรูปแบบนี้
<span dojoType="tooltip" 
connectId="entryField"
caption="xxxxxx"/>

ประเด็นก็คือ แล้ว dojo จะรู้ได้ไงว่าต้องเปลี่ยน dom element นี้ให้เป็น dojo component
Dojo ก็เลยต้อง scan document ทั้งอัน เพื่อที่จะหาว่ามี attribute dojotype อยู่ที่ไหนบ้าง
ยิ่งหน้าจอเรามี dom element เยอะขึ้นเท่าไร ก็ยิ่งเสียเวลามากขึ้นเท่านั้น

การแก้ไขก็คือ จำกัดวงไม่ให้ dojo ต้อง scan เอกสารทั้งหมด
เริ่มด้วยการ set djconfig
<script> 
djConfig = {
..
parseWidgets: false,
searchIds: [],
..
};
</script>

จากนั้นในแต่ละ element ที่ต้องการให้เป็น dojo component
ก็ให้ใส่ script นี้ลงไป
<span dojoType="tooltip" 
connectId="entryField"
caption="xxxxxx"
id="this_is_my_dojo"/>
<script>djConfig.searchIds.push("this_is_my_dojo");</script>

Related link from Roti

Label กับ Form

Label Placement in Forms
บทความนี้เขา track ลูกตา กับ form ที่ align ในแบบต่างๆ
แล้วสรุปให้เราดูว่า ข้อดีข้อเสียเป็นอย่างไร

Related link from Roti

Monday, August 21, 2006

Closures for Java

มี proposol แบบนี้ออกมา ค่อยรู้สึกมีความหวังกับภาษานี้หน่อย
(หลังจากปล่อยให้ C# นำหน้าไปนาน)

ดูตัวอย่างแรกสุดก่อน
public static void main(String[] args) { 
int plus2(int x) { return x+2; }
int(int) plus2b = plus2;
System.out.println(plus2b(2));
}

ในที่สุด Kingdom of Nouns อย่าง java ก็มี verb citizen โผล่เข้ามาแล้ว
ในบรรทัดแรก plus2 ก็คือ Type ชนิด function
ส่วนบรรทัดที่ 2 ก็คือการกำหนดให้ plus2b เป็นตัวแปรที่ reference ไปยัง function plus2

บรรทัดที่ 1 และ 2 จากตัวอย่างข้างบน สามารถยุบเขียนในรูป anonymous function ได้แบบนี้
int(int) plus2b = (int x) {return x+2; };


แถมด้วย syntactic sugar
แทนที่จะต้องเขียนแบบนี้
void sayHello(java.util.concurrent.Executor ex) { 
ex.execute((){ System.out.println("hello"); });
}

ก็สามารถเขียนแบบนี้ได้
void sayHello(java.util.concurrent.Executor ex) { 
ex.execute { System.out.println("hello"); }
}

Related link from Roti

Sunday, August 20, 2006

Emacs & xft

ตั้งแต่ใช้ Emacs มา มีเรื่องขัดใจอยู่อย่างเดียว
ก็คือ text ของ emacs ใน linux มันไม่เป็น anti-aliased
วันนี้ก็ลอง build emacs จาก branch ที่เขา implement feature xft ดู

ขั้นตอนก็คือ
checkout จาก trunk ก่อน

cvs -z3 -d:pserver:anonymous@cvs.savannah.gnu.org:/cvsroot/emacs co emacs

จากนั้นก็สั่ง update จาก branch

cd emacs
cvs up -Pd -r XFT_JHD_BRANCH

สั่ง configure
(ตรงนี้ distro แต่ละ distro คงไม่เหมือนกันนะ
ถ้าดูเอกสารที่คุณ poonlap แนะนำ จะไม่ต้องมี --x-includes กับ --x-libraries
กรณีของผมเป็น fedora core 5, ถ้าไม่มีจะ compile ไม่ผ่าน)

./configure --with-xft --with-gtk --x-includes=/usr/include/X11 --x-libraries=/usr/lib/X11

จากนั้นก็สั่ง

make bootstrap
make install


เท่านี้ก็ได้ emacs ฉบับสวยงาม
แต่ข้อเสียก็คือ มันแสดงภาษาไทยไม่ได้
เศร้า
(poonlap, ถ้าอ่านเจอ ก็ช่วยหาทางแก้ให้หน่อยนะ)

เครื่องผมก็เลยมี emacs มัน 2 แบบเลย
ถ้าดู code ภาษาอังกฤษก็ใช้ build with xft
ถ้าภาษาไทย ก็ใช้แบบธรรมดาไป

Update: มีปัญหา Segment fault เกิดขึ้นบ่อยมาก
ถ้า switch ไปใช้ workspace อื่น

Related link from Roti

Friday, August 18, 2006

Ruby กับ Ingres

หลังจอเฝ้ารอว่าจะมีใครเขียน adapter ให้ ruby สามารถคุยกับ ingres ได้
ในที่สุด ก็รอไม่ไหว หันไปหาทางเลือกอื่น
นั่นคือ ช่องทาง ODBC

solution ก็คือ
  • unixODBC
    อันนี้ไม่มีอะไรพิเศษ ติดตั้งได้จากพวก Package Manager ของ Distro ได้เลย
    ประเด็นถัดมา ก็คือการสร้าง datasource
    ถ้าสร้างด้วยมือ ดูจะโหดร้ายไปหน่อย
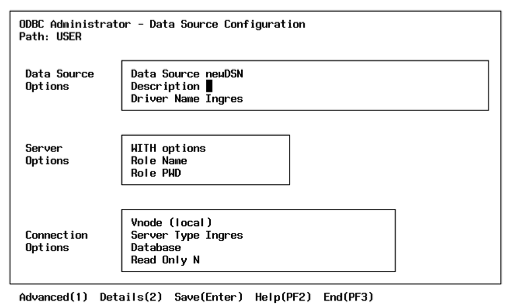
    ingres ก็เลยเตรียม utility ที่ชื่อ iiodbcadmn


  • Ruby ODBC
    ตัวนี้มีปัญหานิดหน่อย
    ตรงวิธีที่เขาเขียน
    เนื่องจากเขาเขียนโดยอิง mysql เป็นหลัก
    พอมาใช้กับ database ตัวอื่น ก็อาจจะเป็นปัญหาบ้าง
    ในกรณีของ ingres ถ้าลอง build แล้ว run testcase ดูจะพบ error นี้
    [pphetra@fedora ruby-odbc-0.9991]$ ruby test.rb sso
    connect.............ok
    create_table........ok
    insert.............../test/20insert.rb:6:in `call': 37000 (2913)
    [unixODBC][Ingres][Ingres ODBC Driver][Ingres]line 1, You cannot assign
    a value of type 'varchar' to a column of type 'integer'.
    Explicitly convert the value to the required type. (ODBC::Error)
    from ./test/20insert.rb:6
    from test.rb:20
    from test.rb:16

    ถ้าเข้าไปดูใน testcase จะเห็น code ที่มีปัญหา หน้าตาเป็นแบบนี้
    $p = $c.proc("insert into test (id, str) values (?, ?)") {}
    $p.call(3, 'FOO')

    ประเด็นที่เป็นปัญหา ก็คือวิธีที่ใช้ในการ binding parameter เข้ากับ statement
    หลังจากไล่ source code ของ ruby-odbc ซักพัก ผมก็เจอจุด quickfix
    ก็เลยแก้ง่ายๆลงไป
    @@ -6265,6 +6266,7 @@
    if (coldef == 0) {
    switch (ctype) {
    case SQL_C_LONG:
    + stype = SQL_NUMERIC;
    coldef = 10;
    break;
    case SQL_C_DOUBLE:

  • Ruby DBI
    ตัวนี้ไม่มีอะไรพิเศษ
    ผมเลือกลงแต่ dbd ที่ต่อเข้า ODBC อย่างเดียว


ขั้นตอนถัดไป ระหว่างรอให้มี ODBC Adapter(สำหรับ rails) ดีๆออกมา
ก็จะทดลองเขียน rails adapter ที่ต่อเข้ากับ ruby dbi ไปพลางๆก่อน
(ใช้ตัวอย่างจาก sqlserver adapter ที่มี mode ที่ใช้ odbc ด้วย)

Related link from Roti

Monday, August 14, 2006

เรื่องเล่าจากทางเหนือ

สมัยเรียนหนังสือ ถึงช่วงปิดเทอมเมื่อไร
ก็จะทำกิจกรรมค่ายอาสา
ขึ้นดอยไปใช้ชีวิตกับชาวเขา
กลางวันช่วยสอนหนังสือเด็ก
กลางคืนช่วยสอนหนังสือผู้ใหญ่
บางวันก็ไปช่วยทำไร่

จบมาแล้ว เวลาเห็นข่าวที่เกี่ยวกับชาวเขา
ก็รู้สึกว่าเป็นความผูกพันที่ต้องติดตามอ่าน

วันนี้อ่านเจอ blog ของ คุณจตุพร วิศิษฎ์โชติอังกูร
ที่ทำงานอยู่ในพื้นที่
เขามีเรื่องเล่าหลายเรื่องที่น่าสนใจทีเดียว

แต่มีอยู่เรื่องที่อ่านแล้วก็เกิดอาการสะดุดทางใจ
เรียนรู้ชีวิตกลางคืน.. ผ่านบาร์อะโกโก้
คือเมื่อก่อนผมก็เคยรวบรวมข้อมูลหญิงบริการที่เป็นชาวเขา
ได้มีโอกาสเห็นสมุดบัญชีของพวกซ่อง ที่จดจำนวนการใช้บริการ
เห็นตัวเลขแล้ว ก็รู้สึกช็อคเหมือนกัน
อธิบายไม่ถูก
คืออยากเห็นคนปฎิบัติต่อคนในฐานะเพื่อนมนุษย์ด้วยกัน
มากกว่าเป็นแค่วัตถุรองรับอารมณ์

Related link from Roti

หนุ่มญี่ปุ่นกับเมืองปาย

ลองอ่านบทสัมภาษณ์ของ หนุ่มญี่ปุ่นคนหนึ่ง
ที่เรียกเมืองปายว่า "บ้าน"
Innerview : Toron

Related link from Roti

Hivemind #2

ลองดูเรื่อง Configuration บ้าง
concept ของ Configuration ใน Hivemind ก็คือ
เวลาเรานำ service ไปใช้, service ย่อมต้องการ parameter บางอย่าง
เพื่อที่จะได้กำหนดพฤติกรรมให้เหมาะกับสภาพแวดล้อมที่ service run อยู่

ใน Hivemind เราแบ่งส่วนของ configuration ออกเป็น 2 ส่วนคือ
  • ส่วนที่ difine นิยาม และการนำไปใช้
    เรียกตรงนี้ว่า Configuration Point
  • ส่วนที่ provide configuration data
    มีศัพท์เรียกว่า Contribution


ดูตัวอย่างดีกว่า
สมมติเรามี service ตัวหนึ่งชื่อ FooService
public interface FooService {

public void connect();

}


public class FooServiceImpl implements FooService {

private List<ServerInfo> serverInfos;

/**
*
@param serverInfo the serverInfo to set
*/

public void setServerInfos(List<ServerInfo> infos) {
this.serverInfos = infos;
}

/* (non-Javadoc)
* @see test.FooService#connect()
*/

public void connect() {
System.out.println("connect to " + serverInfos.get(0).getHost());
}
}


public class ServerInfo {
private String host;
private String port;
private String uri;

// setter & getter ..
}

ในตัวอย่างข้างบนนี้ serverInfos ก็คือ configuration point
ที่เราอยากให้สามารถปรับเปลี่ยนได้ตามบริบทที่ service นี้ไป run อยู่
ดังนั้นใน descriptor file ของเรา เราก็จะกำหนดดังนี้

เริ่มด้วยการกำหนด configuration point ก่อน
<configuration-point id="serverInfo" >
<schema>
<element name="serverInfo">
<attribute name="host" required="true"/>
<attribute name="port" required="false"/>
<attribute name="uri" required="true"/>
<conversion class="test.ServerInfo"/>
</element>
</schema>
</configuration-point>

ให้สังเกตว่าเรามีการ define schema ของรูปแบบของข้อมูลด้วย

จากนั้นก็กำหนดบอกว่า FooService เราต้องการ information จาก configuration-point นี้นะ
<service-point id="foo" interface="FooService">
<invoke-factory>
<construct class="impl.FooServiceImpl">
<set-configuration property="serverInfos" configuration-id="serverInfo"/>
</construct>
</invoke-factory>
</service-point>

สุดท้าย เวลาที่เราต้องการ customize กำหนดค่า serverInfo
เราจะทำผ่าน contribution
โดยรูปแบบข้อมูล ต้องตรงตามที่กำหนดเป็น schema ไว้ใน configuration-point
<contribution configuration-id="serverInfo">
<serverInfo host="128.1.1.10" uri="/app/service"/>
</contribution>


ลองเปรียบเทียบกับ spring บ้าง
ตามตัวอย่างข้างบนนี้ spring จะเขียนเป็นแบบนี้
<bean id="fooService" class="test.impl.FooServiceImpl">
<property name="serverInfos">
<list>
<bean class="test.ServerInfo">
<property name="host" value="128.1.1.10"/>
<property name="uri" value="/app/service"/>
</bean>
</list>
</property>
</bean>


ดูแค่นี้ ก็จะเห็นว่า spring มี configuration ที่ดูเข้าใจง่ายกว่า (จริงๆแล้วขึ้นกับว่า ผู้ดูเป็นใคร?)

แต่ hivemind มีข้อได้เปรียบกว่า spring ตรงที่
contribution ของ hivemind มัน auto-discovery ได้
คือเราสามารถแยก component ออกเป็น module ย่อยๆ
โดยแต่ละ module ก็มี descriptor file ของตัวเอง
ดังนั้นเราอาจจะ package service ไว้ใน module หนึ่ง
แล้วอาจจะ pack contribution ไว้ในอีก module หนึ่ง
เมื่อ registry ของ hivemind load ขึ้นมา มันจะมองหา
descriptor file ที่อยู่ใน classpath ทั้งหมด แล้วประกอบขึ้นมาเป็น registry ให้โดยอัติโนมัติ

Related link from Roti

Sunday, August 13, 2006

Hivemind #1

ช่วงสองสามเดือนมานี่ ชีวิตขลุกอยู่กับ Tapestry
แน่นอนเมื่อโปรเจคใหญ่ขึ้น ซับซ้อนขึ้น
ก็หลีกเลี่ยงไม่ได้ที่จะต้องลงไปแตะ Architecture ที่เป็นฐานรากของ Tapestry
ซึ่งก็คือ Hivemind

Hivemind เรียกตัวเองว่า Service and Configuration MicroKernel
โดย Service ก็คือ POJO ที่สามารถร้อยเข้าหากันด้วยวิธี Dependency Injection เช่นเดียวกับ Spring
ส่วน Configuration ก็คือ การ define data ที่ service ต้องการใช้

ลองดูตัวอย่างการ configuration ของ hivemind

เริ่มด้วยการ define service

<service-point id="foo" interface="Foo">
...
</service-point>


เทียบกับ Spring ที่ใช้ concept เป็น Bean
<bean id="foo" class="test.impl.FooImpl">
...
</bean>

ความแตกต่างในเบื้องต้น จะเห็นได้ว่า bean ใน spring เราจะระบุชื่อที่รวม package name ด้วย
ส่วน hivemind ชื่อ package จะถูก define ไว้ที่ระดับ document root ของ xml

ส่วนประเด็นที่สอง hivemine นิยมประกาศให้ชัดไปเลยว่า
service ที่ expose นั้นมี interface เป็นอย่างไร
ซึ่ง client ที่ต้องการใช้ service สามารถ query ตามชื่อของ service ได้
IPreferenceService svr = (IPreferenceService) registry
.getService(IPreferenceService.class);


ทีนี้ลองไปดูวิธีร้อย service เข้าหากันบ้าง
เอาวิธีร้อยแบบ declarative (ไม่ได้ใช้ autowire)
ในส่วนของ Hivemind
<service-point id="dao" interface="IPreferenceDao">
<create-instance class="impl.PreferenceDapImpl"/>
</service-point>

<service-point id="preferenceService" interface="IPreferenceService">
<invoke-factory>
<construct class="impl.PreferenceServiceImpl">
<set-service property="dao" service-id="dao"/>
</construct>
</invoke-factory>
</service-point>

เทียบกับ spring
<bean id="dao" class="test.impl.PreferenceDaoImpl"/>

<bean id="preferenceService" class="test.impl.PreferenceServiceImpl">
<property name="">
<ref bean="dao"/>
</property>
</bean>


จะเห็นว่าถึงตอนนี้ hivemind กับ spring ก็ดูเหมือนๆกัน
ต่างกันตรงที่ใช้ wording กันคนละแบบ
แต่จริงๆแล้วพอถึงจุดนี้ มันเริ่มเกิดความแตกต่างในวิธี implement แล้ว
ใน Hivemind ถ้าเราลอง get service ขึ้นมา
object ที่เราได้จะมี class เป้น SingletonProxy
ส่วนของ Spring ถ้า get bean ขึ้นมา object ที่ได้
จะเป็น class ตรงตามที่ define ไว้
// hivemind
System.out.println(registry.getService(PreferenceServiceImpl.class);
// => <SingletonProxy for test.preferenceService(test.IPreferenceService)>

// spring
System.out.println(factory.getBean("preferenceService"));
// => test.impl.PreferenceServiceImpl

ดูอย่างนี้แล้ว Hivemind จะออกไปในแนว Lazy initialize มากกว่า
คือถ้า proxy ยังไม่ถูกใช้งาน object จริงๆ ก็จะยังไม่ถูกสร้างขึ้น
แต่ในกรณี spring bean ลูกๆที่ถูกอ้างถึง ต้องมีการ initialize สร้างเป็น object
ก่อนที่จะถูก set ให้กับ bean แม่

พักอยู่ที่จุดนี้ก่อน
ไว้ถ้ามีเวลา จะลงไปลึกถึงเรื่อง interceptor,
configuration point, service management

Related link from Roti

Saturday, August 12, 2006

Derived Folder (File) ใน Eclipse

ใครที่ใช้ eclipse กับ project ที่มีขั้นตอนการ build ที่ซับซ้อน
อาจจะพบปัญหาว่าเวลาเราสั่ง open resources
แล้ว eclipse มันแสดง file ที่เราไม่ต้องการเห็น

เราสามารถ disable directory ที่เราไม่ต้องการ ให้ "open resources" ค้นหา
ได้โดยการ click ขวา เพื่อเลือก properties ของ folder นั้น
จากนั้นก็ tick ที่ Derived checkbox

Related link from Roti

Thursday, August 10, 2006

ใครๆก็เปลี่ยนไปใช้ OSGi

Websphere version 6.1 เปลี่ยนมาใช้ OSGi เป็น fundamental architectural layer
ใครที่เคย change directory เข้าไปใต้ lib path ของ websphere แล้วเห็น jar file
เป็นร้อย (พูดให้เวอร์ไว้ จำนวนจริงเท่าไร ไม่เคยนับ) ก็จะไม่เห็นแล้ว
เพราะมันจะย้ายไปอยู่ใต้ plugins แทน (ใน format แบบเดียวกับที่เราเห็นใน eclipse)

ส่วน JOnAS version 5 ก็มี proposol ว่าจะเขียนบน OSGi เหมือนกัน

สำหรับ Geronimo ก็เห็นมีการ push กันใน mailing list มานานแล้ว

Tuscany ก็มีการเปิด isuue เรื่อง initial OSGi support effort เหมือนกัน

Related link from Roti

Wednesday, August 09, 2006

Hit and Run


... hit and run micromanagement. That’s where you micromanage one developer in a spurt of activity and then suddenly disappear from that developer’s life for a couple of weeks while you run around micromanaging other developers.

ฟังคุ้นๆ

จาก "The Command and Control Management Method"

Related link from Roti

Tuesday, August 08, 2006

Dirvish

เห็นมีคนพูดถึง Dirvish ว่ามี concept คล้ายๆ feature Time Machine ใน Leopard

With dirvish you can maintain a set of complete images of your filesystems with unattended creation and expiration. A dirvish backup vault is like a time machine for your data.

Related link from Roti

Ruby-like syntax

เห็น code_poet เขาเขียนเรื่อง FinderTemplate
ไม่รู้ว่าเป็นพฤติกรรมร่วมกันหรือเปล่า
สำหรับคนที่ใช้ ruby แล้ว
พอกลับมาเขียน java ก็มักเลียนแบบ syntax บางอย่างของ ruby
คือที่คิดอย่างนี้ ก็เพราะว่าผมก็มีอาการอย่างนี้เหมือนกัน

Related link from Roti

Friday, August 04, 2006

Tapestry Asset

Asset ในความหมายที่ Tapestry ใช้ ก็คือ binary หรือ text file ที่ browser ต้องการใช้
ไม่ว่าจะเป็น image file, javascript file, css file ฯลฯ

การที่ Tapestry define Asset ออกมาเป็นเรื่องเป็นราวแบบนี้
อย่างน้อยก็ช่วยให้เราจัดการกับ Resource File ได้ง่ายขึ้น
เช่นแทนที่จะยุ่งกับ physical file โดยตรง ก็ไปจัดการผ่าน Logical file แทน
ทำให้จัดการเรื่องพวก internationalize ได้ง่ายขึ้น
(พวกเปลี่ยนรูปที่แสดง ตาม locale ของ user)
รวมทั้งทำเรื่อง dynamic asset ณ runtime ได้ง่ายขึ้น

Tapestry แบ่งที่มาของ Asset ออกเป็น 2 ประเภทคือ
  • Context Asset
    asset ที่อยู่ใน Context Directory ของ Web application
  • Classpath Asset
    asset ที่อยู่ใน classpath ไม่ว่าจะเป็นใน WEB-INF/classes หรือใน jar ต่างๆ

asset ประเภท Context Asset ถือเป็นเรื่องปกติธรรมดาอยู่แล้วไม่มีประเด็นให้พูดถึง
แต่ asset ประเภท classpath นี่สิ มีประโยชน์มากในแง่ของการ reuse
เพราะช่วยให้เราเขียน component เป็น module (ภายในมีทั้ง html, gif, javascript, ฯลฯ)
ที่นำมาใช้ใหม่ได้่ง่าย

การเข้าถึง Classpath Asset จะทำผ่าน AssetService
โดย url ที่ใช้เข้าถึงจะมีหน้าตาแปลกๆแบบนี้

http://localhost:8080/fin/app?digest=ff8e3332b16d745764befd7c6956ad9a&path=%2Fwcf%2Fweb%2Fjs%2Fwcfutil.js&service=asset

สังเกตว่ามี parameter ที่ชื่อ digest อยู่ด้วย
ทำไมต้องมีค่า digest ด้วย?

มูลเหตุที่ต้องมี digest แปะมา ก็เพื่อป้องกันไม่ให้ผู้ไม่หวังดี
ใช้ service นี้ไปดึงเอาพวก class file ออกมาตามใจชอบ
(เนื่องจาก service นี้สามารถดึงเอาอะไรก็ได้ที่อยู่ใน classpath)

ประเด็นหนึ่งของการมี checksum แปะแบบนี้ก็คือ
มันจะกิน cpu time ทุกครั้งที่มีการ request asset นี้
Tapestry ก็เลยออกแบบให้มี cache ในส่วน generate digest

ผลพลอยได้ที่มาโดยไม่ตั้งใจ ก็คือ เมื่อเนื้อหา file เปลี่ยน
ค่า digest ก็จะเปลี่ยนไปได้วย (แต่ต้อง clear cache ก่อน)
ทำให้เราไม่เจอปัญหาเรื่อง browser cache
(เหมือนกับที่ rails generate timestamp แปะท้าย url
ที่ request ขอ javascript ก็เพื่อป้องกันปัญหานี้เหมือนกัน)

ปัญหาของการมี digest อีกอย่างก็คือ
link ทุก link ต้องเกิดจากการ generate ของ server
(เพราะ server จะต้องแปะค่า digest ให้)
ทำให้เราไม่สามารถใช้ javascript load ข้อมูลแบบ dynamic ได้
(dojo ใช้กลไกการ load แบบ dynamic)

เพื่อแก้ปัญหานี้ Tapestry4.1 ก็เลยมีการเพิ่ม feature UnprotectedAssets
เพื่อให้เราเลือก config ได้ว่า Asset กลุ่มไหนต้องมี Digest
กลุ่มไหนที่ไม่ต้องมี Digest

Related link from Roti

Wednesday, August 02, 2006

Tapestry4.1

Tapestry 4.1 release ออกมาแล้ว
version นี้มีจุดที่น่าสนใจก็คือ
  • integrate dojo toolkit เข้าไปใน framework เลย
    ลองดูตัวอย่างในเอกสารเขา

    สมมติเรามี html นี้อยู่
    <div id="foo">Hello</div>

    ถ้าเราอยากดัก event onMouseOver
    โดยถ้า event เกิดแล้วให้ไป trig listener ที่อยู่บน server side
    @EventListener(elements = "foo", events = "onMouseOver")
    public void watchText() {
    ...
    }

    แค่นี้เอง

    กลไกภายในที่เกิดขึ้นข้างใน
    ก็ประมาณว่า จะมีการร้อย event ที่เกิดใน DOM
    เข้ากับ dojoEvent ซึ่งจะทำการ trig ไปยัง tapestry service
    ซึ่งจะ call เข้าหา method ที่ต้องการให้
  • สามารถ render ผลลัพท์เป็น JSON ได้
  • bundle dojo อยู่ใน tapestry.jar เรียบร้อย
    ไม่ต้อง download ติดตั้ง
  • กลไกในส่วน client validation เปลี่ยนไป implement ด้วย dojo
  • มีการ map dojo widget เข้าเป็น tapestry component จำนวนหนึ่ง
    ทำให้สะดวกในการใช้มากยิ่งขึ้น

ฮ่วย ออกช้าไปสองเดือน
เมื่อสองเดือนที่แล้ว ผมนั่งปวดหัวกับการ integrate dojo + tapestry4.0 + JSON

Related link from Roti