Monday, August 22, 2005

Message Driver Bean with Spring

ActiveMQ เป็น Opensource JMS provider ตัวหนึ่งทีี่มีคนนิยมใช้
เช่น Geronimo ก็เอาไป integrate เป็น Message Service ของตัวเอง

ใน ActiveMQ มี sub project ตัวหนึ่งที่ชื่อ Jencks
ทำหน้าที่เป็น lightweight JCA container
สามารถ config เข้าไปใน Spring Framework เพื่อที่จะให้บริการ Message Driver Bean ได้
(โดยไม่ต้องมี J2ee Application Server)

Message Bean


ทดลองเขียน Message Bean ง่ายๆ
package mx.test.mq;

import java.util.Enumeration;

import javax.jms.JMSException;
import javax.jms.Message;
import javax.jms.MessageListener;
import javax.jms.TextMessage;

public class EchoBean implements MessageListener {

public void onMessage(Message msg) {
try {
TextMessage txt = (TextMessage) msg;
System.out.println(txt.getText());
} catch (JMSException je) {
je.printStackTrace();
}
}
}

จากนั้นก็ add Container เข้าไปใน Spring
<?xml version="1.0" encoding="UTF-8"?> 
<!DOCTYPE beans PUBLIC "-//SPRING//DTD BEAN//EN" "http://www.springframework.org
/dtd/spring-beans.dtd">
<beans>
<bean id="jencks" class="org.jencks.JCAContainer">
<property name="bootstrapContext">
<bean class="org.jencks.factory.BootstrapContextFactoryBean">
<property name="threadPoolSize" value="25"/>
</bean>
</property>

<property name="resourceAdapter">
<bean id="activeMQResourceAdapter" class="org.activemq.ra.ActiveMQRe
sourceAdapter">
<property name="serverUrl" value="tcp://localhost:61616"/>
</bean>
</property>
</bean>

<bean id="monitor" factory-method="addConnector" factory-bean="jencks" singl
eton="true">
<property name="activationSpec">
<bean class="org.activemq.ra.ActiveMQActivationSpec">
<property name="destination" value="Monitor.Queue"/>
<property name="destinationType" value="javax.jms.Queue"/>
</bean>
</property>

<property name="ref" value="echoBean"/>
</bean>

<bean id="echoBean" class="mx.test.mq.EchoBean" singleton="true"/>

</beans>

จากนั้นก็ทดลองเขียน Java Class ที่ใช้ในการ start service
package mx.test.mq;

import org.springframework.context.support.ClassPathXmlApplicationContext;

public class Main {

/**
* @param args
*/
public static void main(String[] args) {
ClassPathXmlApplicationContext appContext =
new ClassPathXmlApplicationContext(
new String[] {"beans.xml"});
}

}


ทดลองเขียน Client เพื่อส่ง Message


เราจะใช้ Spring JmsTemplate เข้ามาช่วย
โดยเขียน Spring Config file ดังนี้
<?xml version="1.0" encoding="UTF-8"?> 
<!DOCTYPE beans PUBLIC "-//SPRING//DTD BEAN//EN" "http://www.springframework.org
/dtd/spring-beans.dtd">
<beans>
<bean id="jmsFactory" class="org.activemq.ActiveMQConnectionFactory">
<property name="brokerURL">
<value>tcp://localhost:61616</value>
</property>

</bean>

<!-- Spring JMS Template -->
<bean id="jms" class="org.springframework.jms.core.JmsTemplate">
<property name="connectionFactory">
<ref local="jmsFactory"/>
</property>
<property name="defaultDestinationName" value="Monitor.Queue"/>
</bean>
</beans>

ทดลองส่ง Message ดังนี้
package mx.test.mq;

import javax.jms.JMSException;
import javax.jms.Message;
import javax.jms.Session;

import org.springframework.context.support.ClassPathXmlApplicationContext;
import org.springframework.jms.core.JmsTemplate;
import org.springframework.jms.core.MessageCreator;

public class Client {

/**
* @param args
*/
public static void main(String[] args) {
ClassPathXmlApplicationContext appContext = new ClassPathXmlApplicationC
ontext(
new String[] { "client.xml" });
JmsTemplate jms = (JmsTemplate) appContext.getBean("jms");
jms.send(new MessageCreator() {
public Message createMessage(Session session) throws JMSException {
return session.createTextMessage("hello queue world");
}
});
}

}


Note: ก่อนจะ run อย่าลืม start ActiveMq ให้เรียบร้อยก่อน

เท่าที่ทดสอบดู ก็ work ok ดี แต่ไม่ค่อยชอบอยู่จุดหนึ่ง ตรง dependency file
ที่ต้องใช้ ลองดูว่าต้องใช้อะไรบ้าง
* connector-api.jar -> JCA api
* geronimo-transaction.jar
* geronimo-connector.jar
* geronimo-kernel.jar
* geronimo-j2ee.jar
* jencks.jar
* activemq-ra.jar
* activemq-core.jar
* geronimo-spec-jms.jar -> JMS api
* geronimo-spec-j2ee-management.jar (javax.management.j2ee)
* concurrent-1.3.4.jar
* commons-logging.jar
กลุ่มล่างๆไม่ติดใจอะไร เพราะเป็น Spec Api ที่ต้อง import อยู่แล้ว
แต่กลุ่มบน จะเห็นว่า dependency กับ Geronimo เยอะมาก

ที่สนใจ JMS ตอนนี้ก็เพราะว่า สามารถเอามาใช้เป็น infrastructure ใน
การ integrate rails, java เข้าหากันได้ (ผ่านทาง TTMP protocol ของ ActiveMQ)
โดยให้ rails เป็นส่วน Web Application และใช้ Java เป็น Business Tier

Related link from Roti

Java Preferences

เป็น feature หนึ่งใน JDK1.4+ ที่อนุญาติให้เราเก็บ Application Preferences ของเราได้
โดยแต่ละ Platform ก็จะมีวิธีเก็บที่ต่างกัน
  • Windows เก็บลง Windows Registry
  • Unix เก็บลง File System
  • Mac Os X เก็บลง plist file ใน Library Folder


เราสามารถเลือก Preferences Store ได้ 2 แบบคือ
  • Per User
  • Per System


แต่ละแบบจะมีที่เก็บต่างกันไป
อย่างเช่นใน Unix
ที่เก็บของ Per User ก็จะอยู่ที่ ​~/.java/.userPrefs
แต่ถ้าเป็น Per System ก็ขึ้นอยู่กับว่า ถ้าที่ /etc มี directory .java
ก็จะไปสร้างที่ /etc/.java/.systemPrefs
แต่ถ้าไม่มี directory นั้น ก็จะไปใช้ ที่ /JAVA_HOME/.systemPrefs แทน

Note: ที่เก็บกรณี unix นี้สามารถ override ได้โดยใช้ System Properties
  • java.util.prefs.userRoot กำหนด root directory ของ user (default คือ user.home)
  • java.util.prefs.systemRoot กำหนด root directory ของ system

(ระวังด้วยว่า ถ้าเป็น IBM JDK หรือ Rockit JDK อาจจะไม่ใช่ค่านี้ก็ได้)

ส่วนใน OS X
ถ้าเป็น per User ก็จะเก็บใน ~/Library/Preferences
ถ้าเป็น per System ก็จะอยู่ใน /Library/Preferences
โดยจะประกอบด้วย 2 file ก็คือ file com.apple.java.util.prefs.plist
จะใช้เก็บ node path อย่างเดียว
แล้วก็ file plist ที่ใช้เก็บค่าจริงๆ อีก 1 file ต่อ 1 node (เฉพาะ leaf node)

การเก็บค่าลง Preferences สามารถใช้ Datatype ได้ดังนี้

  • String
  • boolean
  • ByteArray
  • double
  • float
  • int
  • long


กรณีที่ใช้ String หรือ ByteArray ต้องระวังข้อจำกัดในเรื่อง
ขนาดของ value ที่เก็บ โดยค่า maximum length ที่ยอมให้เก็บได้
ก็คือ 8192 characters

ส่วนข้อจำกัดอื่นๆ ก็คือ
ขนาดของ key ก็คือ ความยาวห้ามเกิน 80 characters
ขนาดของ node name ห้ามยาวเกิน 80 characters

Feature ที่น่าสนใจอีกอย่าง ก็คือ สามารถสั่ง Import และ
Export ข้อมูลใน preferences ได้

นอกจากนี้เราสามารถ Implements Preferences ของเราเองได้
โดย implements Interfaces PreferencesFactory
และบอกให้ vm รู้โดยการ set System Property -Djava.util.prefs.PreferencesFactory=my.PreferencesFactory

อ่านเพิ่มเติม

Related link from Roti

Sunday, August 21, 2005

Javascript 101

อ่านเจอ Idea ของ 'bact ในเรื่องการใช้ closure ในการ modify tree structure แล้ว
ก็เลยไปค้นหาดูบทความดีๆ ที่พูดเรื่อง closure พบบทความที่น่าสนใจก็คือ
Javascript Closures
หลังจากนั่นอ่่าน(ด้วยความทรมาน) อยู่พักใหญ่ ก็เลยเกิดแรงบันดาลใจว่า
เห็นควรจะได้ฤกษ์ทำความเข้าใจในเรื่อง Javascript ของตัวเองเสียที (หลีกเลี่ยงมานานแล้ว)

Note: ข้อควรระวัง. Javascript นี้อ้างอิง ECMAScript เป็นหลัก
ไม่ได้ดูเรื่อง browser compatiblilty เลย


Execution Context


Note: คำอธิบายนี้เป็น abstract
การ implement ของ Javascript Engine จริงๆ อาจจะมี object model
ซับซ้อนกว่านี้


Execution Context ก็คือ Object ธรรมดานี่แหล่ะ
เมื่อเราเริ่มต้น run javascript
เจ้า javascript engine ก็จะทำการ initialize "Global Execution Context"
ให้เรา โดยมี method (หรือ function) จำนวนหนึ่งมาให้ เช่น Date, encodeURI, isNAN, ...
(พวกนี้ก็คือ build in function ของ javascript นั่นเอง)

เมื่อไรก็ตามที่เรามีการ call function
เจ้า Javascript engine ก็จะทำการสร้าง Execution Context Object
ตัวใหม่ให้เรา และทำการ push current Execution Context ลงใน
Stack ก่อน เพื่อที่ว่าเมื่อมีการ return ออกจาก function แล้ว
ก็จะ pop เอา Execution Context ที่อยู่ใน Stack ขึ้นมาเป็น current Execution Context ต่อไป

ลองดูตัวอย่าง

1: function callMe() {
2: var x = 10;
3: }
4:
5: a = 'hi';
6: callMe();

เมื่อเริ่มต้น run Javascript นี้.
เจ้า Javascript Engine ก็จะทำการ
Initialize new Global Execution Context ขึ้นมา.

เมื่อ Engine อ่านเจอบรรทัดที่ 1 ที่เป็นการประกาศ function
ก็จะทำการ add function นี้เข้าเป็นสมาชิก (method)
ของ Global Execution Context

ส่วนที่บรรทัดที่ 5 ที่มีการ initialize variable.
variable a ตัวนี้จะถูกสร้างเป็นสมาชิก (property) ของ
current scope ซึ่งก็คือ Global Execution Context นั่นเอง

ที่บรรทัดที่ 6 มีการ call ไปที่ function callMe
JavaScript Engine ก็จะสร้าง Execution Context ใหม่ขึ้นมา,
จากนั้นก็ push Global Execution Context ลง stack ก่อน
สุดท้ายก็ set Execution Context ตัวใหม่นี้ เป็น current Execution Context

ที่บรรทัดที่ 2 มีการ initialize variable x
variable x จะถูกสร้างให้เป็นสมาชิกของ current
Execution Context และเมื่อจบจาก function callMe
current Execution Context ก็จะถูก Garbage ทิ้งไป (ตัวแปร x
ก็จะหายไป) และทำการ pop Execution Context จาก stack
ขึ้นมา set เป็น current Execution Context แทน

__proto__


ตัวนี้เป็น internal Object Reference ซึ่งชี้ไปยัง Object ที่เราต้องการให้เป็นต้นแบบ
(ทุก Object ภายใน javascript จะมี property __proto__ เสมอ)
ดูตัวอย่างดีกว่า เข้าใจง่ายกว่า

1 : function Fruit() {
2 : this.eatable = true;
3 : }

4 : function Apple() {
5 : this.color = "red";
6 : }

7 : Apple.prototype = new Fruit();
8 : var apple1 = new Apple();

9 : print (apple1.color); // ==> red
10: print (apple1.eatable); // ==> true
11: print (apple1.x);

ที่บรรทัดที่ 7 เรากำหนดให้ prototype property
ของ Apple Function ไห้ชี้ไปยัง Object ที่สร้างขึ้นมาจาก Object Fruit

เมื่อไรก็ตามที่เราเรียกมีการ new Apple()
Instance ที่สร้างขึ้นใหม่นี้จะถูก set ค่า __proto__ ให้ชี้ไปยัง
ค่าที่กำหนดไว้ใน prototype property

ที่นี้คำถาม ก็คือ ทำไมต้องมี __proto__
__proto__ จะถูกใช้เมื่อเรามีการ access properties ของ Object นั้น
แล้ว JavaScript Engine ไม่สามารถหา property ชื่อที่เราต้องการใน Object นั้นได้
เจ้า Javascript engine ก็จะขยับออกไปหา property นั้นจาก
Object ที่ __proto__ ชี้อยู่แทน ถ้าหาไม่เจออีก ก็ขยับขึ้นไปอีก
จนกว่า จะเจอค่า __proto__ ที่เป็น null

จากข้างบนตัวอย่างข้างบน เราสามารถเขียนแบบกำหนด __proto__
ได้ตรงๆดังนี้

function Fruit() {
this.eatable = true;
}

function Apple() {
this.color = 'red';
}
y = new Apple();
z = new Fruit();
y.__proto__ = z;

print (y.color);
print (y.eatable);


ข้อควรระวังในการใช้ Inner Function


จากตัวอย่างนี้

function Position(x, y) {
this.dump = function() {
println ("x = " + x + ", y = " + y);
}
}

p = new Position(10, 20);
p.dump();

การที่เราประกาศแบบนี้ ทุกครั้งที่เรา new Position ขึ้นมา
จะเกิด Object dump ขึ้นมาด้วย ถ้ามี Position 100 instance
ก็จะมี Object dump 100 instance ด้วยเช่นกัน

ดังนั้นเป็นการดีกว่าที่จะกำหนดเป็น prototype แทนเพื่อให้ลดการใช้ memory ลง

function Position(x, y) {
this.x = x;
this.y = y;
}

Position.prototype.dump = function () {
println ("x = " + this.x + ", y = " + this.y);
}

p = new Position(10, 20);
p.dump();


ปัญหาอีกอย่างของ inner function ก็คือ
memory leak

function add(x) {
return function innerAdd(y) {
return x + y;
}
}

a = add(10);
println (a(2)); // ==> 12

การที่เรากำหนด function add ไว้อย่างนี้
ทำให้เกิดปัญหา memory leak ได้
เนื่องจากในขณะที่เรา new function innerAdd
ขึ้นมานั้น innerAdd จะมี reference ไปยัง
กลุ่มของ object ที่อยู่ใน execution context จำนวนหนึ่ง

และเมื่อมีการ return ค่ากลับออกมา
Garbage ก็จะพยายาม release resources
ที่ถูกจองใน Execution Context ของ funcion add
แต่ก็ไม่สามารถ release ได้ (เพราะยังมี pointer จาก a อ้างถึงอยู่)
วิธีที่ดีกว่า ก็คือ

function add(x) {
this.x = x;
return addAgain;
}

function addAgain(y) {
return this.x + y;
}

a = add(10);
println (a(2)); // ==> 12

Related link from Roti

Friday, August 19, 2005

ใช้ Spring AOP ในการ initialize Hibernate Lazy Properties

ปัญหาของการใช้ Hibernate ตัวหนึ่งที่เชื่อว่าทุกคนคงจะเคยเจอ (โดยเฉพาะพวกที่
พัฒนา Web Application) ก็คือ ประเด็นเรื่อง LazyInitializationException
ซึ่งเกิดจากการพยายาม access Lazy Properties หลังจากที่ได้มีการ
close Session ไปแล้ว

สภาพปัญหา
สมมติว่าเราออกแบบ Class Customer กับ Class CustomerHistory
โดย CustomerHistory ต้องการจะไว้ใช้เก็บประวัติการซื้อของลูกค้า


เวลาเรา Mapping เข้ากับ Hibernate
Navigation จาก customer ไปยัง CustomerHistory จะ config ได้ดังนี้
<set
name="customerHistory"
lazy="false"
cascade="none"
sort="unsorted"
order-by="invoiceDate"
>

<key
column="customer_id"
>
</key>
<one-to-many
class="domain.CustomerHistory"
/>

</set>

จะเห็นว่าใน code ตัวอย่างนี้มี lazy="false"

เมื่อไรก็ตามที่สั่ง query Customer นี้เช่น
List results = session.createQuery("from Customer as c").list();

Note:สำหรับผู้ที่สงสัยว่าทำไมไม่เขียน session.find("from Customer...")
เพราะว่าใน Hibernate3 Class Session ไม่มี method find ให้ใช้แล้ว


Hibernate ก็จะจัดการ query โดยการ
select * from Customer
จากนั้น แต่ละ Customer ที่ได้มา
select * from customer_history

ซึ่งจะเห็นว่าถ้าเอาไปใช้งานในหน้าจอประเภทสอบถามที่ดึง customer ทีเดียวหลายๆคน
หรือหน้าจอรายงาน ก็จะเกิดปัญหาในด้าน Performance Issue แน่นอน

ดังนั้นเรามักจะกำหนดให้ lazy="true" เสียมากกว่า
ซึ่งเมื่อกำหนดเช่นนี้แล้ว Hibernate จะยังไม่ select ข้อมูลจาก customer_history
จนกว่าจะมีการ access จริงเกิดขึ้น (เช่นมีการเรียกใช้ customer.getCustomerHistory().size())
ซึ่งการ set lazy="true" นี่แหละที่เป็นที่มาของปัญหา
LazyInitializeException

ดังนั้นในกรณีที่เรารู้ว่า Object เราจะถูกใช้หลังจากที่ Session close แล้ว
และมีการ access lazy Properties ด้วย. Hibernate เปิดโอกาสให้เรา
initialize Lazy Property ด้วยคำสั่ง Hibernate.initialize(..)

ในแง่การปฎิบัติแล้ว วิธี Hibernate.initialize ก็สามารถใช้การได้ดี
แต่ในแง่ความสวยงามของ Design แล้วดูมันผิดที่ิผิดทางอยู่
สุดท้ายพวกคนที่ใช้ Spring ก็เลยมี Idea ที่จะแก้ไขปัญหานี้ด้วยการใช้
Spring AOP เข้ามาช่วย ​(เพื่อให้การกำหนด initialize property
มีลักษณะเป็น Declarative มากขึ้น)

ลองมาดูวิธีการที่เขาใช้
เริ่มจากสถานะการณ์ปกติที่เราใช้ Spring ก่อน

define Service Layer ด้วย Interface
public interface ICustomerServices {    
public List findAllCustomer();
}


ใน config file เรา declare CustomerService โดยใช้ Proxy
เพื่อจะได้ใส่ hibernate interceptor ที่ทำหน้าที่ open, close Session
ให้เราอัตโนมัติ
<bean id="myHibernateInterceptor" 
class="org.springframework.orm.hibernate3.HibernateInterceptor">
<property name="sessionFactory">
<ref bean="mySessionFactory"/>
</property>
</bean>

<bean id="customerServiceTarget" class="service.CustomerService">
<property name="sessionFactory">
<ref bean="mySessionFactory"/>
</property>
</bean>

<bean id="customerService"
class="org.springframework.aop.framework.ProxyFactoryBean">
<property name="proxyInterfaces">
<value>service.ICustomerServices</value>
</property>
<property name="interceptorNames">
<list>
<value>myHibernateInterceptor</value>
<value>customerServiceTarget</value>
</list>
</property>
</bean>


เมื่อไรก็ตามที่เราต้องการ Initialize Properties เราก็สามารถ
แทรก Interceptor เข้าไปได้ดังนี้
<bean id="cust-service-findall_initialize" 
class="org.springmodules.aop.framework.TouchingNameMatchMethodAdvisor">
<property name="mappedNames">
<value>findAllCustomer</value>
</property>
<property name="advice.ognl">
<list>
<value>#returned.{customerHistory.size}</value>
</list>
</property>
</bean>

และทำการแทรก Interceptor เข้าไปใน proxy ดังนี้
<bean id="customerService"
class="org.springframework.aop.framework.ProxyFactoryBean">
<property name="proxyInterfaces">
<value>service.ICustomerServices</value>
</property>
<property name="interceptorNames">
<list>
<value>myHibernateInterceptor</value>
<value>cust-service-findall_initialize</value>
<value>customerServiceTarget</value>
</list>
</property>
</bean>

Class TouchingNameMatchMethodAdvisor จะคอยดักว่ามีการ เรียกใช้ method
ที่กำหนดหรือไม่ ถ้ามีการเรียกใช้ ก็จะใช้ OGNL Expression ที่เรากำหนด
เข้าไป access property

สรุป
ในแง่ Design การยกเอา Initilize code ออกมาเป็น Declarative ดู
มี style กว่า แต่ในแง่ปฏิบัติและความยุ่งยากแล้ว อาจจะไม่คุ้มกันก็ได้
เพราะถ้าเขียนเป็น code แล้วจะมี code แค่เพียง 1 บรรทัด แต่ถ้ายกออกมา
เป็น declarative แล้วต้องเขียน code ขึ้นอีก 12 บรรทัด

Note: Class TouchingNameMatchMethodAdvisor อยู่ใน Project SpringModules
และยังไม่รวมอยู่ใน release build ของ SpringModules


อ่านเพิ่มเติม

Related link from Roti

Thursday, August 18, 2005

Spring Package ทำพิษ

วันนี้จะทดสอบ Spring Function ใหม่ๆ ก็เลย setup project
ใน eclipse กะว่าจะลอง Hibernate3
ได้เรื่องเลย แค่ buildSessionFactory ก็เจอ exception
AbstractMethodError ในส่วนของการ getDataMajorVersion ใน postgres jdbc
นั่งดูอยู่ต่างนาน เพราะว่าเฉพาะตัว hibernate3 ก็เคย test แล้ว
มันทำงานได้นี่หว่า
สุดท้าย ก็เจอว่าเป็น bug ตัวนี้ SPR-1185
ทางแก้ก็คือ อย่าใช้ hibernate3.jar ที่มากับ spring

Note: อย่าไว้ใจ jar ที่ได้มาง่ายๆ

Related link from Roti

Tuesday, August 16, 2005

SpellChecker with Lucene

SpellChecker เป็น API extension ของ lucene ช่วยในการ implement feature
ที่ใช้ในการตรวจสอบ word ที่เข้ามาว่าถูกต้องตรงใน dictionary หรือไม่
กรณีไม่ถูก ก็สามารถ suggest คำที่ไกล้เคียงที่สุดให้ได้ด้วย

โดยส่วนใหญ่เรามักจะใช้ algorithm minimum edit distance
ในการ solve หาคำที่ไกล้เคียงที่สุด แต่ใน SpellChecker นี้
ใช้ technique ที่เรียกว่า n-gram

การใช้งาน SpellChecker จะเริ่มต้นด้วยการ create Index ที่จะใช้ search ก่อน
โดย index นี้ใช้ api ของ lucene ในการสร้างขึ้นมา

ส่วนข้อมูลที่จะป้อนเข้าไปเก็บใน index นี้จะต้องป้อนผ่าน
Dictionary ซึ่งทาง SpellChecker เตรียม Dictionary
มาให้เรา 2 แบบคือ
  • PlainTextDictionary
    ใช้กับ input word ที่อยู่ในรูป Text File
  • LuceneDictionary
    ใช้กรณีที่เราต้องการ extract word มาจาก lucene index ที่มีอยู่แล้ว


ตัวอย่างการสร้าง index
import org.apache.lucene.index.IndexReader;
import org.apache.lucene.search.spell.Dictionary;
import org.apache.lucene.search.spell.LuceneDictionary;
import org.apache.lucene.search.spell.SpellChecker;
import org.apache.lucene.store.Directory;
import org.apache.lucene.store.FSDirectory;

...

IndexReader reader = null;
try {

Directory indexdir = FSDirectory.getDirectory("/tmp/luceneIndex", false);
Directory spellIndex = FSDirectory.getDirectory("/tmp/spellChecker", true);

reader = IndexReader.open(indexdir);
Dictionary dict = new LuceneDictionary(reader, "name");
SpellChecker spellChecker = new SpellChecker(spellIndex);
spellChecker.indexDictionnary(dict);

} finally {
if (reader != null) {
reader.close();
}
}


ข้อมูลที่เก็บไว้ใน index จะแยกเก็บเป็น 1 document(lucene document)
ต่อ 1 word ที่ป้อนเข้าไป
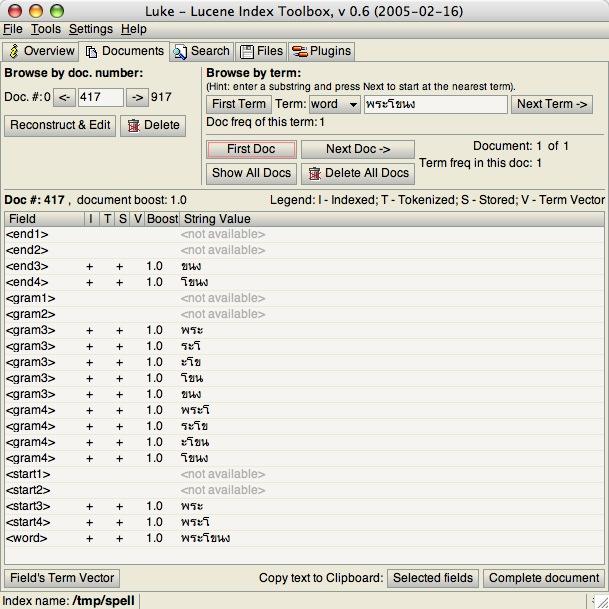
สมมติว่าเรามี word "พระโขนง" เจ้า SpellChecker จะเก็บเป็น index ดังนี้


เห็นได้ว่ามีการใช้ 3-gram กับ 4-gram เป็นหลักเนื่องจากคำนี้มีความยาวมากพอ
โดยจะแบ่งออกเป็น 4 ส่วนคือ start, gram, end, word

ส่วนกรณีการ search หา ก็สามารถทำได้ดังนี้
กรณีที่ตรวจว่ามีคำนี้ใน Spell Dict. ของเราหรือไม่ ก็ใช้คำสั่งนี้
Directory spellIndex = FSDirectory.getDirectory("/tmp/spell", false);       
SpellChecker spell= new SpellChecker(spellIndex);
spell.exist("พระโขนง");

Note: SpellCheck จะใช้ method ของ lucene ที่ชื่อ docFreq
ในการ search แบบนี้

ส่วนกรณีที่ต้องการหา word ที่คล้ายกันก็ใช้คำสั่งนี้
(เลข 2 คือ parameter ที่บอกว่าต้องการ similar word แค่ 2 ตัวพอ)
String[] strs = spell.suggestSimilar("พระโขง", 2);

results:
พระโขนง
พระแสง


ขั้นตอนการทำงานภายใน ของ suggestSimilar
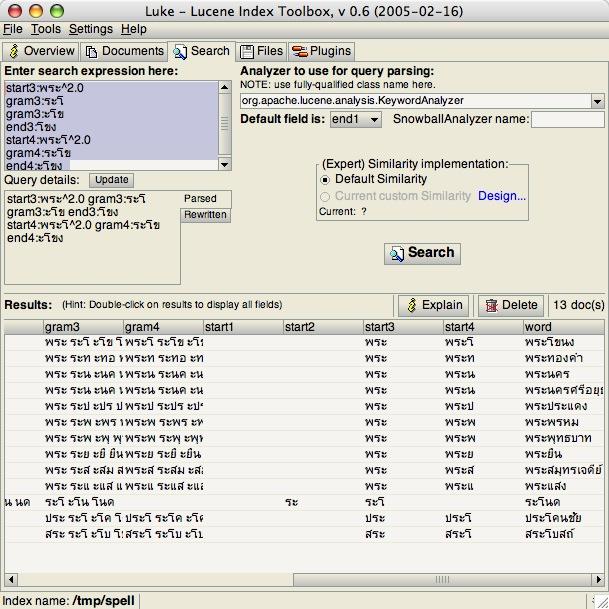
จาก word ที่เข้ามา SpellChecker จะจัดการสร้าง Boolean Query ที่มี query แบบนี้
start3:พระ^2.0
gram3:ระโ
gram3:ะโข
end3:โขง
start4:พระโ^2.0
gram4:ระโข
end4:ะโขง

จะเห็นได้ว่า startN จะถูก boost ด้วย 2

ถ้าลองดูผลลัพท์ที่ได้ จะเห็นว่าได้มาเยอะเชียว (ตัวอย่างข้อมูลที่ใช้เป็น dictionary
ของ อำเภอทั่วประเทศ)


จากนั้นผลการ search ที่ได้ จะถูกคำนวณ score ด้วย algorithm Levenshtein distance
และเรียงลำดับก่อน return กลับมาให้ผู้ใช้

อ่านเพิ่มเติม

Related link from Roti

Monday, August 15, 2005

แสงอุ่นๆ


ROCKWELL KENT
Baker of the Bread of Abundance, 1945
The Baker of the Bread of Abundance, which appears to illustrate its own story, showcases Kent’s propensity toward strong, contrasting light and color. Here, the family dining at the table is awash in the warm illumination that radiates from the loaf of bread. In the large hands of the looming figure, Kent may have intended the bread to symbolize American abundance and family togetherness at the end of World War II.

Related link from Roti

Sunday, August 14, 2005

ข้อควรระวังในการ set Gregorian Calendar

ใช้มาตั้งนานพึ่งรู้ว่ามีโอกาศ set ผิดได้ ลองดูตัวอย่างนี้
เราสามารถ set GregorianCalendar ได้ 2 แบบ คือ
ผ่านทาง Constructor หรือ ผ่านทาง method set
ของมัน
GregorianCalendar cal1 = new GregorianCalendar(2005, Calendar.AUGUST, 12);
GregorianCalendar cal2 = new GregorianCalendar(2005, Calendar.AUGUST, 12, 0, 0,
0);
GregorianCalendar cal3 = new GregorianCalendar();
cal3.set(Calendar.MILLISECOND, 0);
cal3.set(Calendar.SECOND, 0);
cal3.set(Calendar.MINUTE, 0);
cal3.set(Calendar.HOUR, 0);
cal3.set(Calendar.YEAR, 2005);
cal3.set(Calendar.MONTH, Calendar.AUGUST);
cal3.set(Calendar.DATE, 12);

ค่า TimeInMillis ของ cal1 กับ cal2 จะมีค่าตรงกัน
ส่วนค่าของ cal3 มีโอกาศผิดได้ ขึ้นอยู่กับว่าเรา
run program นี้ตอนกี่โมง ถ้าเรา run ตอนเข้า ค่า cal3
ก็จะถูกต้อง แต่ถ้าเรา run ช่วงบ่ายค่า cal3 ก็จะไม่ถูกต้อง
(คำว่าถูกต้องหมายถึง ค่าที่ได้จาก method getTimeInMillis
ของ cal3 มีค่าตรงกับ cal2.getTimeInMillis())

ที่เป็นเช่นนี้เพราะว่า algorithm ในการคำนวณ timeInMillis
ของ GregorianCalendar มันจะคำนวณก่อนว่าเรามีการ
set ค่า HOUR_OF_DAY หรือ HOUR
ถ้า set ค่า HOUR มันจะนำ AM_PM value มาคำนวณด้วย
ดังนั้นในกรณีเรา run ช่วงบ่าย ตอนที่เรา new GregorianCalendar()
เราจะได้ AM_PM = Calendar.PM ทำให้ค่า HOUR ที่เรา set
เป็น 0 นั้นหมายถึงตอน 12.00 นาฬิกา
// from GregorianCalendar.java
int hourOfDayStamp = stamp[HOUR_OF_DAY];
int hourStamp = stamp[HOUR];
int bestStamp = (hourStamp > hourOfDayStamp) ? hourStamp : hourOfDayStamp;
// Hours
if (bestStamp != UNSET) {
if (bestStamp == hourOfDayStamp) {
// Don't normalize here; let overflow bump into the next period.
// This is consistent with how we handle other fields.
millisInDay += internalGet(HOUR_OF_DAY);
fieldMask |= 1 << HOUR_OF_DAY;
} else {
// Don't normalize here; let overflow bump into the next period.
// This is consistent with how we handle other fields.
millisInDay += internalGet(HOUR);
fieldMask |= 1 << HOUR;

// The default value of AM_PM is 0 which designates AM.
if (stamp[AM_PM] != UNSET) {
millisInDay += 12 * internalGet(AM_PM);
fieldMask |= 1 << AM_PM;
}
}
}

ดังนั้นในกรณีที่ต้องการ set ให้ถูกต้อง ก็ต้องเลือก set
โดยใช้ HOUR_OF_DAY หรือ HOUR
ในกรณีใช้ HOUR ก็ต้องทำการ set AM_PM ด้วย
// use HOUR_OF_DAY
cal3.set(Calendar.HOUR_OF_DAY, 0);

// use HOUR & AM_PM
cal3.set(Calendar.HOUR, 0);
cal3.set(Calendar.AM_PM, Calendar.AM);

Related link from Roti

Friday, August 12, 2005

Bash History

เมื่อก่อนสมัยยังไม่มี bash ก็มักจะใช้ set -o vi
เพื่อให้ใช้ vi command ในการ access history command ได้

ปัจจุบัน มี bash ก็ไม่ค่อยได้ set -o vi แล้ว (จริงๆแล้วไม่ค่อยได้ใช้ shell เท่าไรแล้วด้วย)
ใช้แต่ลูกศรขึ้นลง scroll ไปมา
พึ่งมารู้วันนี้เองว่า history ของ bash ทำอะไรได้เยอะเหมือนกัน

เริ่มด้วย สมมติว่าเราพึ่งสั่ง ls -l | head ไป
และต้องการสั่งซ้ำอีก แทนที่จะใช้ลูกศรขึ้นไปหา
เราสามารถใช้คำสั่ง !l แทนได้ โดยมันจะหาคำสั่งล่าสุดที่ขึ้นต้นด้วยตัว l ให้เอง

หรือถ้าใช้ !?head แทนก็ได้ โดยมันจะหาคำสั่งล่าสุด
ที่มีคำว่า head

ส่วนการ search ก็สามารถใช้ ^r เพื่อเข้าสุ่ reverse incremental history search mode
เมื่อหา command ที่ต้องการเจอแล้ว ก็สั่งทำงานด้วยการ enter
หรือจะสัง ^j เพื่อ edit command ก่อน (กรณียกเลิกค้นหาใช้ ^c)

ถ้าสั่ง ^head^tail ก็เป็นการเรียกใช้ command ก่อนหน้า แต่
แทนที่คำว่า head ด้วยคำว่า tail

สั่ง history | grep -i 'head' เพื่อ list คำสั่ง
ที่มีคำว่า head จากนั้นก็ใช้ !linenumber เพื่อเลือกคำสั่งที่ต้องการ

ถ้าเราดูใน history จะเห็นว่ามันมีคำสั่งพื้นๆ เช่น ls, edit อยู่เต็มไปหมด
กรณีที่เราไม่ต้องการเก็บคำสั่งเหล่านี้ใน history ก็ใช้
export HISTIGNORE="&:ls:[bf]g:exit"
มี trick หนึ่งก็คือ ถ้าเราใช้ [ \t]* ใน HISTIGNORE
กรณีที่เราสั่งคำสั่งที่ไม่ต้องการให้เก็บใน history
ก็เพียงแต่เติม space ไปข้างหน้าคำสั่ง

Related link from Roti

DSL with Ruby

Martin Fowler เขียนบทความ Using the Rake Build Language
มีประเด็นที่น่าสนใจอยู่อันก็คือ Domain Specific Language

The basic idea of a domain specific language (DSL) is a computer language that's targeted to a particular kind of problem, rather than a general purpose language that's aimed at any kind of software problem.

ที่สนใจประเด็นนี้ เพราะว่า Ruby language มันมีความยืดหยุ่นมาก
ทำให้เราสามารถสร้าง Domain Language เพื่อให้เหมาะกับงานของเราได้
อย่างเช่น Rake ที่ออกแบบมาสำหรับ build process
หรือ ActiveRecord ที่ออกแบบมาสำหรับ ORM

ตัวอย่าง Rakefile
task :codeGen do
# do the code generation
end

task :compile => :codeGen do
#do the compilation
end

task :dataLoad => :codeGen do
# load the test data
end

task :test => [:compile, :dataLoad] do
# run the tests
end


ตัวอย่าง ActiveRecord
class Item < ActiveRecord::Base
belongs_to :category
validates_associated :categoory
validates_format_of :done_before_type_case
,:with=>/[01]/,
,:message=>"must be 0 or 1"
validates_presence_of :description
validates_length_of :description
,:maximum=>40

end


จริงๆแล้วพวก syntax ที่เราเห็นนั้น มันก็คือ method ธรรมดานี่แหล่ะ
อย่างเช่น
task :name => [:prereq1, :prereq2]

จริงๆแล้ว ถ้าเขียนให้ดูเป็นขั้นเป็นตอนหน่อย ก็เขียนได้ดังนี้
hash = Hash.new
hash[:name] = [:prereq1, :prereq2]
task(hash)

ถ้าเราไปเปิด source code ของ rake ดูจะเห็นว่า
เขา define method task ไว้ดังนี้
# Declare a basic task.
#
# Example:
# task :clobber => [:clean] do
# rm_rf "html"
# end
#
def task(args, &block)
Task.define_task(args, &block)
end

จะเห็นได้ว่า block do...end ถูก pass เป็น object ไปไว้ในตัวแปร block
เมื่อต้องการ execute ก็เพียงแต่สั่ง block.call

ใน Rake มี feature Multiple Definitions
ซึ่งเปิดโอกาสให้เราเขียน definition กระจายแบบนี้ได้
task :name
task :name => [:prereq1]
task :name => [:prereq2]
task :name do |t|
# actions
end


feature ที่ทำให้เขียนแบบนี้ได้ มันเป็นคุณสมบัติของ ruby language เลย เช่น
class Person 
def initialize(name)
@name = name
end
end

p1 = Person.new("polawat")

class Person
def sayhi
puts "Hello #{@name}."
end
end

p1.sayhi

เห็นได้ว่า เราสามารถ extend class Person
ด้วยการประกาศ definition class ใหม่อีกรอบ
(ไม่มีข้อจำกัดเรื่อง scope เราสามารถ extend class
ของ ruby เช่น String ก็ได้)


อ่านเพิ่มเติม

Related link from Roti

ห้องน้ำ

อ่านเจอใน Roumen 's weblog

อันไหนคือห้องน้ำชาย อันไหนคือห้องนำ้หญิง
ใครรู้ภาษาจีน ช่วยเฉลยด้วย
Roumen เขายังไม่เฉลยเลย
(พยายามเดาอักษรภาพแล้ว ดูไม่เห็นออกเลย
ว่าตัวอักษรตัวไหนเหมือนผู้ชาย)

Related link from Roti

Unsigned char in C <--> Signed byte in Java

ช่วงนี้ได้มีโอกาสใล่ดู algorithm ที่เกี่ยวกับการ encrypt, decrypt
ที่เขียนด้วย C แล้วต้องแปลงให้เป็น java เลยนั่งค้นหาดูว่ามีประเด็นอะไรบ้าง
ที่อาจเป็นปัญหา

ประเด็นแรกก็คือ เรื่อง byte ของ Java เป็น signed byte
แต่ใน c จะเป็น unsigned char
ปัญหาจะเห็นชัด กรณีที่เรา shift bit
เช่น
byte b1 = (byte) 0x80;          // in binary -> 10000000
byte b2 = b1 >> 4;
System.out.println(b2); // print -> -8

byte b1 = (byte) 0x80;
int b2 = b1 >>> 4;
System.out.println(b2); // print 268435448

ปัญหาของกรณีนี้ก็คือ 0x80 พอแปลงเป็น byte แล้ว มันก็คือ -128 (มี sign bit เป็น 1)
พอ shift bit แล้วก็ได้เรื่องเลย
ทางแก้ก็คือ ให้เรา & 0xff กับ byte ก่อน shift
byte b1 = (byte) 0x80;
byte b2 = (byte) ((b1 & 0xff) >> 4);
System.out.println(b2); // print -> 8

byte b1 = (byte) 0x80;
int b2 = (b1 & 0xff) >> 4;
System.out.println(b2); // print -> 8

การแปลง byte เป็น int ก็ใช้กฎเดียวกัน
byte b1 = (byte) 0x80 ;
int i1 = b1 & 0xff;
int i2 = b1;
System.out.println(i1); // print 128
System.out.println(i2); // (wrong for unsigned byte) print -128


ที่นี้บางครั้งที่เราต้องการแปลง byte array ให้เป็น int value หรือ long value
ก็ใช้การ & 0xff เช่นเดียวกัน
ตัวอย่างเช่น
public static int toInt(byte[] bs) {
return ((bs[3] & 0xFF) << 0) +
((bs[2] & 0xFF) << 8) +
((bs[1] & 0xFF) << 16) +
((bs[0] & 0xFF) << 24);
}

เราสามารถดูตัวอย่าง source code ของ Java
ได้ที่ class java.io.Bits ซึ่งถูกเรียกใช้จาก
ObjectInputStream, ObjectOutputStream
น่าเสียดายที่ class นี้ไม่ได้ประกาศเป็น public class
ทำให้ไม่สามารถเรียกใช้งานในโปรแกรมเราได้

Related link from Roti

Thursday, August 11, 2005

Struts Ti

Struts Ti เป็น derivative ของ struts 1.x
rewrite framework เพื่อให้ง่ายต่อการ develop
(idea หลายๆส่วนมาจาก ruby on rails)

Controller

  • No configuration - everything done through annotations
  • ใช้ XDoclet กรณีที่เป็น JDK1.4
  • จะใช้หรือไม่ใช้ Form object ก็ได้
  • controller เขียนแบบ POJO
  • มี annotation สำหรับทำ Validation
  • Result forwards view ไม่ต้อง define ก็ได้ มี default เป็นค่าเดียวกับ action name

Action Mapping URL จะอยู่ในรูป

http://HOST/ACTION_NAME/PARAM_VALUE1/PARAM_NAME2/PARAM_VALUE2


FormValidation
ออกแบบใหม่

Jsp Tag
ใช้แนวทางของ WebWork2
Note: ในส่วน tag นี้ jsp กับ rails จะไม่ต่างกันนัก
แต่ rails จะ integrate template กับ controller
เป็นเนื้อเดียวกันกว่า (template mix เข้ากับ controller
ทำให้มองเหมือนกันว่า ตัวเองเป็น controller)


เพิ่มเรื่อง Page Flow State Management เข้ามา
โดยใช้แนวทางจาก Beehive Page Flow

Related link from Roti

Wednesday, August 10, 2005

Dependency Injection is Ruby

วันนี้อ่านเจอ Presentation ใน OSCon 2005 ของ Jim Weirich
ซึ่งพูดถึงเรื่อง Dependency Injection กับ ruby

มีภาพตัวอย่างการเปรียบเทียบ Java Class กับ Ruby Class ที่โดนใจ
ก็เลย copy มาให้ชม


ชอบที่พูดถึงตรงนี้
DI really becomes useful in really large projects
There aren’t that many really large Ruby projects


Dependency Injection Frameworks for Ruby

Note: DIM กับ Matz มี link ไปหา source code ใน Presentation

หลังจากดูตัวอย่าง source code ของ DIM กับ Matz
แล้วรู้สึกมืน ชอบวิธีการที่พวก spring, hivemind
ใช้ xml เป็น descriptor มากกว่า

Related link from Roti

Newbie in Linux Server Installation

ปกติทำงานด้าน Development ไม่ได้ยุ่งกับการติดตั้ง Server มานานแล้ว
ช่วงนี้ได้กลับมาปัดฝุ่น นั่ง config Linux Server ได้ความรู้ขึ้นอีกเยอะเลย
เริ่มด้วยการ resize ขนาดของ ​LVM
ก็สั่ง lvresize เพื่อเพิ่มเนื้อทีี่ของ volumn
่ปรากฎว่าเนื้อที่ใน Logical Volume เพิ่มขึ้นแล้ว
แต่เนื้อที่ใน file system ที่ mount เข้ามายังขนาดเดิมอยู่
ก็เลยนั่งค้น net ปรากฎว่ามีจดหมายที่เขียนถามเรื่องนี้เหมือนกัน
แต่ไม่มีใครตอบเลย สุดท้ายหลังจากงมเข็มไปมาพักใหญ่ ก็ฟลุ๊คไปเจอคำสั่ง
resize_reiserfs ก็เลย bingo
นึกเห็นใจพวก newbie ขึ้นมาทันทีเลย
โถเขียนจดหมายไปถามแล้วก็ไม่มีใครตอบ

ระหว่างนั้นก็อ่านเจอพวกชุดคำสั่ง autofs, automount
ซึ่งช่วยจัดการ mount filesystem ให้เราอัติโนมัติ เมื่อเราต้องการใช้
(เช่นเมื่อเรา cd เข้าไปใน directory ที่เป็นจุด mount point นั้น
หรือเมื่อเราพยายาม access path ใน mount point นั้น)
น่าสนใจดีมาก โดยเฉพาะในส่วนที่ mountpoint นั้นจะ automatic unmount เอง
หลังจากที่เราไม่ได้ใช้งานในระยะเวลาหนึ่ง (ค่า default คือ 5 นาที)
ที่ชอบอีกจุดหนึ่งก็คือ AutoFS 's map สามารถกำหนด map ในลักษณะ
Wildcard Key ได้

Note: ใน suse มีปัญหาในกรณีที่เรากำหนด timeout ใน
auto.master เช่น
/auto /etc/auto.misc --timeout 30
ถ้าอยู่ใน suse ตัว "-" แรกจะหายไป ทำให้เราต้องใส่เป็น "---"
หรือไม่ก็เลี่ยงไปใช้ "-t 30" แทน

Related link from Roti

Monday, August 08, 2005

Config VPN with OpenVPN

ช่วงนี้กำลังหา solution ในการเชื่อมต่อ ระหว่าง
network ที่บ้าน กับ network ที่ทำงาน
เมื่อก่อนที่ใช้ windows ก็สามารถใช้ CIPE ในการทำ vpn ได้
เนื่องจากมีทั้ง version linux และ win32
(บน win32 ยังมีปัญหาในการติดตั้งบน XP อยู่บ้าง แต่ไม่ยากเกินไปนัก
สามารถหาวิธีแก้ใน mail-archive ได้)
มาตอนนี้เปลี่ยนไปใช้ OS X แล้ว ก็เลยต้องขวนขวายหา solution ใหม่

ตอนแรกก็ดู IPSec ไว้ เพราะว่ามีมาให้กับ Freebsd อยู่แล้ว
แถมใน Tiger ก็มี gui สำหรับ config และเรียกใช้งานด้วย
หลังจากปลุกปล้ำอยู่ 1 วันเต็มๆ ก็ถอดใจ
เนื่องจาก case ที่ config นี้เป็น case dynamic ip
ทั้งฝั่งที่บ้านและฝั่งที่ทำงาน ซึ่งน่าจะเป็น case ที่ config
ยากสุดสำหรับ IPSec

หลังจาก search net ไปมา ก็ไปเจอเข้ากับ OpenVPN
หลังจากอ่านคู่มืออยู่สักพัก ก็พบทางสว่างทันที
ก็เลย load เอา source มา build เอง
ตัว Server ที่ทำงานมี OS เป็น SuSE Enterprise 9
การ build ก็เลยไม่ยาก ขาดเหลือ lib อะไร
ก็เปิดแผ่นเอา
ส่วนการ build ที่ Mac ก็ใช้ fink
ในการ install library lzo เพิ่ม

การ Config ก็ไม่ยากเย็นอะไร เพราะใน distribution
มีตัวอย่าง config file มาให้พร้อมสรรพ
แถมยังมี document ที่อธิบายค่อนข้างละเอียดดีทีเดียว
เริ่มด้วยการ generate พวก Certificate ทั้งหลาย
เนื่องจากในการเชื่อมต่อระหว่าง client กับ server
จะมีการตรวจสอบ Certificate ของกันและกัน
โดยทั้งสองฝ่ายจะยอมรับ connection ต่อเมื่อ
certificate ของทั้งสองฝ่าย ถูก sign โดย
Root CA อันเดียวกัน
(ข้อดีของ OpenVPN ก็คือมันเตรียม shell script
ที่ใช้ในการสร้าง key หรือ sign key ไว้เสร็จสรรพ
ไม่ต้องทรมานไปนั่งอ่านวิธีใช้ openssl อีก)

ในส่วน Server ก็จะมี config เพิ่มในส่วนของ
Route table ที่จะ push ไปให้ Client
เพื่อที่จะกำหนดว่า client มีสิทธิ access subnet
อะไรได้บ้าง

ส่วนการ Config OpenVPN สำหรับ OS X
มีข้อแม้เพิ่มเติมจากพวก Unix ก็คือ
ต้องมีการติดตั้ง tun/tap driver for Mac OS X
ซึ่งเป็น kernel extension ด้วย
อันนี้แหล่ะที่ดูน่ากลัวเล็กน้อย
เพราะว่ากลัวว่าติดตั้งแล้ว จะทำให้ OS ไม่เสถียร
ก็เลยไปหาเอกสารมาอ่านทำความเข้าใจสักหน่อย
ว่าถ้ามีปัญหาแล้วจะ uninstall ยังไง

ในส่วนของ OS X ก็มีคนทำ gui สำหรับเรียกใช้ง่ายๆ
ชื่อ Tunnelblick

โดย download package ของ Tunnelblick มีให้เราครบหมดเลย
ทั้ง tun-tap, openvpn, gui

Note: ในกรณีที่เรา build openvpn เอง แล้วเลือก
install ใน path ที่ไม่ใช่ /usr/local/sbin
จะทำต้องทำ link มาไว้ที่นี่ด้วย เพราะเจ้า
TunnelBlick มันฝัง hardcode ไว้ใน source code
เลยว่า จะเปิด openvpn ได้จากตำแหน่งนี้เท่านั้น

Related link from Roti

Sunday, August 07, 2005

Java Puzzle

อ่านเจอในเอกสาร presentation ใน javaone 2005
ก็เลยลอกมาให้ดู
public class AnimalFarm{ 
public static void main(String[] args) {
final String pig = "length: 10";
final String dog = "length: " + pig.length();
System.out.println("Animalsare equal: " + pig == dog);
}
}


public class Assignment { 
public static void main(String[] a) throws Exception {
int tricky = 0;
for (int i = 0; i < 3; i++)
tricky += tricky++;
System.out.println(tricky);
}
}


public class Loop {
public static void main(String[] args) {
int[][] tests = { { 6, 5, 4, 3, 2, 1 }, { 1, 2 }, { 1, 2, 3 },
{ 1, 2, 3, 4 }, { 1 } };
int successCount = 0;
try {
int i = 0;
while (true) {
if (thirdElementIsThree(tests[i++]))
successCount++;
}
} catch (ArrayIndexOutOfBoundsException e) {
}
System.out.println(successCount);
}

private static boolean thirdElementIsThree(int[] a) {
return a.length >= 3 & a[2] == 3;
}
}


public class Mod {
public static void main(String[] args) {
final int MODULUS = 3;
int[] histogram = new int[MODULUS];
int i = Integer.MIN_VALUE;
// This loop iterates over all intvalues
do {
histogram[Math.abs(i) % MODULUS]++;
} while (i++ != Integer.MAX_VALUE);
for (int j = 0; j < MODULUS; j++)
System.out.print(histogram[j] + " ");
}
}


อันสุดท้ายนี่งงอยู่ตั้งนาน สุดท้ายเปิด javadoc ดูแล้วค่อยร้อง อ๋อ

Related link from Roti