Wednesday, April 06, 2005

ใช้ commons.lang ช่วยเขียน hashCode, equals Method

ใครที่เคยเขียน Java Object จะพบว่า
ในบาง use case จำเป็นต้องมีการ overide equals กับ hashCode method
(ปกติใน object ที่เราไม่ได้ implement equals method
ความหมายของ equals ก็คือดูว่าเป็น instance เดียวกันหรือไม่
แต่ถ้าเราต้องการเปลี่ยนความหมายของ equals
ให้เป็นในลักษณะว่า property ทุกๆตัวเท่ากันหรือไม่แทน
ก็ต้อง override equals method ซึ่ง java object มี
constrain ว่าถ้าเรา overide equals method เมื่อไร
ก็ควรจะต้อง override hashCode method ด้วย
)

การเขียน method 2 อันนี้เราสามารถใช้
jakarta-commons-lang เข้ามาช่วยได้ โดยใช้ class
  • HashCodeBuilder
  • EqualsBuilder
ตัวอย่างการใช้งานกรณี hashCode
public class Person {
String name;
int age;
boolean isSmoker;
...

public int hashCode() {
// you pick a hard-coded, randomly chosen, non-zero, odd number
// ideally different for each class
return new HashCodeBuilder(17, 37).
append(name).
append(age).
append(smoker).
toHashCode();
}
}

หรือจะใช้ reflection แทนก็ได้
  public int hashCode() {
return HashCodeBuilder.reflectionHashCode(this);
}

ส่วนกรณี equals ก็เช่นเดียวกัน
  public boolean equals(Object o) {
if ( !(o instanceof MyClass) ) {
return false;
}
MyClass rhs = (MyClass) o;
return new EqualsBuilder()
.appendSuper(super.equals(o))
.append(field1, rhs.field1)
.append(field2, rhs.field2)
.append(field3, rhs.field3)
.isEquals();
}
ถ้าใช้ reflection
  public boolean equals(Object o) {
return EqualsBuilder.reflectionEquals(this, o);
}

ส่วนใครที่ใช้ Eclipse ถ้าอยากให้ชีวิตง่ายขึ้นกว่านี้อีก
ก็ต้องใช้ Commonclipse ซึ่งมี plugin ที่ช่วย generate
method ให้อีกที (ใช้ common lang builder เหมือนกัน)

Note: กรณีที่ใช้ hibernate มักจะมี
ข้อสงสัยว่าเราควรจะ override equals และ hashCode หรือไม่
ในกรณี use case ปกติ เราไม่จำเป็นต้อง override equals หรือ hashCode
เราจะ override ต่อเมื่อ
- it is a used as a composite primary key class
- instances of that class, loaded in different Hibernate Sessions, are in the same Set (or should be compared)
ส่วนรูปแบบการ implement ปกติจะใช้
    public boolean equals(Object other) {
if ( !(other instanceof Client) ) return false;
Client castOther = (Client) other;
return new EqualsBuilder()
.append(this.getId(), castOther.getId())
.isEquals();
}
// Note: id is object id (surrogate identifier) of this object

public int hashCode() {
return new HashCodeBuilder()
.append(getId())
.toHashCode();
}

สถานะการณ์จะยุ่งยากขึ้นอีกถ้ามีการ compare proxy object กับ real object
อ่านเพิ่มเติมการถกเถึยงประเด็นเหล่านี้ได้ที่ this forum

Related link from Roti

Tuesday, April 05, 2005

Classifier4J

Classifier4J เป็น opensource สำหรับทำ Text Classification
มองหามานานแล้ว พึงเจอ project นี้เป็นตัวแรกที่เป็น opensource
ก็เลย load มาทดลองดู

ใน core package จะมี Classifier ให้เราใช้ 2 แบบก็คือ
ผมทดลอง download ตัว source มา compile เอง
โดยใช้ maven เป็นตัว build
ลำดับการ build เท่าที่ลองมั่วดูก็คือ
ต้อง build core ก่อนโดย cd core แล้วสั่ง maven jar:install
กรณีที่ต้องการ build optional ด้วยนั้นจะติดปัญหาว่า
ในส่วน dependency file ชี้ไปยัง repository name ที่ไม่ถูกต้อง
ให้ทำการแก้ไข project.xml ใน optional directory เสียก่อน
โดยเปลี่ยนส่วน dependency จากของเดิมให้เป็นตามนี้
  <dependency>
<groupId>classifier4j</groupId>
<artifactId>Classifier4J</artifactId>
<version>0.6</version>
</dependency>

จากนั้นก็สั่ง maven jar:install เช่นเดียวกัน

จากการทดลองเล่นดู พบว่ามีปัญหากับภาษาไทย
ก็เลยไล่ code ดูพบว่า ตัว DefaultTokenizer ที่ให้มา
นั้น implment ง่ายๆโดยใช้ method split ของ String Class
ซึ่งไม่สามารถตัดคำไทยได้แน่นอน
ก็เลยเขียน Tokenizer ที่ใช้ BreakIterator ขึ้นมา
public class BreakTokenizer implements ITokenizer {
public String[] tokenize(String input) {
ArrayList list = new ArrayList();
BreakIterator bt = BreakIterator.getWordInstance();
bt.setText(input);
int start = bt. first ();
for (int end = bt. next (); end != BreakIterator. DONE; start = end, end = bt. next ()) {
String tmp = input.substring(start, end);
list.add(tmp);
}
return (String[]) list.toArray(new String[0]);
}
}


นอกจากนี้ยังพบว่า VectorClassifier
นั้นยังเขียนไม่เรียบร้อยนัก ขาด method หรือ constructor
สำหรับ set custom Tokenizer ไปก็เลย แก้ code
เพิ่ม method setTokenizer แล้วก็สั่ง build ใหม่

ตัว code ที่ทดลองใช้ง่ายๆ (ยังไม่มีเรื่อง stopword ไทย)
มีตัวอย่างดังนี้
 public static void main(String[] args) throws ClassifierException {
TermVectorStorage store = new HashMapTermVectorStorage();
VectorClassifier cs = new VectorClassifier(store);
BreakTokenizer tk = new BreakTokenizer();
cs.setTokenizer(tk);

cs.teachMatch("สวัสดีครับนี่คือภาษาไทย");
System.out.println(cs.classify("สวัสดี ภาษาไทย"));

IWordsDataSource ds = new SimpleWordsDataSource();
BayesianClassifier bcs = new BayesianClassifier(ds, tk);
bcs.teachMatch("สวัสดีครับนี่คือภาษาไทย");
System.out.println(bcs.classify("สวัสดี ภาษาไทย"));
}


ผลลัพท์ที่ได้จากการ run
0.7071067811865476
0.99

Related link from Roti

Monday, April 04, 2005

Free (and powerfull) Window Installer

เมื่อก่อนเคยใช้อยู่ตัวหนึ่ง(จำชื่อไม่ได้แล้ว)
ตอนนั้นใช้สำหรับลงโปรแกรมที่เขียนด้วย java+Swing
การใช้ก็ตรงไปตรงมา ระบุ file, directory
ทีติดตั้ง แล้วก็ customize text หรือ icon

พึ่งมาเจอตัวนี้ NSIS: Home
เข้าท่าดีตรงที่เราเขียนเป็น script แทน
ว่าจะ install อย่างไร
ซึ่งทำให้เราเขียน installer ที่ซับซ้อนได้

ตัวอย่าง script
ตัวอย่าง script ที่ install web application บน tomcat
register conduits with the Palm HotSync Manager
ตัวอย่างการตรวจ Java Runtime และ automatic download
Install Java Web Start Application (offline install)

Related link from Roti

Windows Installer สำหรับ Eclipse RCP

เป็น plugin ที่ช่วยสร้าง window installer file
สำหรับ RCP (Rich Client Platform) Product
มี Free Edition ที่สามารถ install โดยใช้ Software Updates Feature
1. Select the menu "Help > Software Updates > Find and Install".
2. Choose "Search for new features to install"
3. Click "New Remote Site", and enter the XtremeJ update site URL "http://www.xtremej.com/updates/"
4. Select the "XtremeJ RCP Builder Feature" and proceed to finish the installation.

ดูคู่มือได้ที่ XtremeJ RCP Builder User's Guide

Related link from Roti

การใช้ Eclipse Compiler (JDT) ใน Ant

เราสามารถใช้ java compiler ของ Eclipse ใน ant build file ได้
โดยผ่านชองทางที่ ant กำหนด นั่นก็คือ property build.compiler
ตัวอย่าง
<project default="compile">

<target name="init" if="eclipse.running">
<property name="build.compiler"
value="org.eclipse.jdt.core.JDTCompilerAdapter" />
</target>

<target name="compile" depends="init">
<echo>debug build.compiler = ${build.compiler}</echo>
<javac srcdir="." destdir="./target" />
</target>

</project>

จากตัวอย่างเราจะใช้ property "eclipse.running"
เป็นตัวตรวจสอบว่า run อยู่ภายใต้ eclipse หรือไม่
ถ้าใช่จึงจะใช้ JDT

Note: ข้อพึงระวังก็คือในตอนที่ run ant ใน Eclipse
ให้กำหนด option Runtime jre เป็น "Run in the same JRE..." ด้วย

Related link from Roti

Friday, April 01, 2005

XDoclet2 Terminate?

วันนี้อ่านพบ Hibernate 3.0 release แล้ว
ก็เลยตามดูว่า xdoclet มีความคืบหน้าในเรื่อง
การ support dtd ตัวใหม่ของ Hibernate 3.0
แค่ไหน
เท่าที่ตามเข้าไปดูใน xdoclet site
พบว่ามีสัญญาณที่ไม่ดีสำหรับ project นี้
โดยเฉพาะตัว xdoclet2 (ที่โปรยหัวไว้ 2 ปีมาแล้ว)
ใน cvs source ไม่พบว่ามี code ขยับมา 2 เดือนแล้ว
นอกจากนี้ก็ยังพบว่า ปีก่อนช่วงเดือน
june-november code ไม่ขยับเลย

เป็นอันปิดบัญชีสำหรับ xdoclet ไปได้แล้ว
ดังนั้นใน case Hibernate 3.0 ถ้าเกิดต้องใช้
ขึ้นมาคงต้องเข้าไปแก้ hibernate-module เองแล้ว
(ดีที่ architecture ของ xdoclet 1.x นั้น
ดีพอใช้อยู่แล้ว การเขียน module หรือ customize
module ก็เลยไม่หนักหนานัก)

Related link from Roti

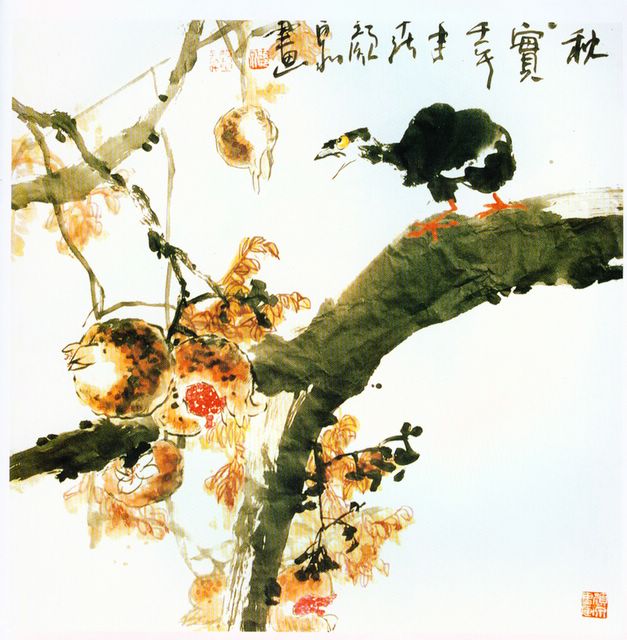
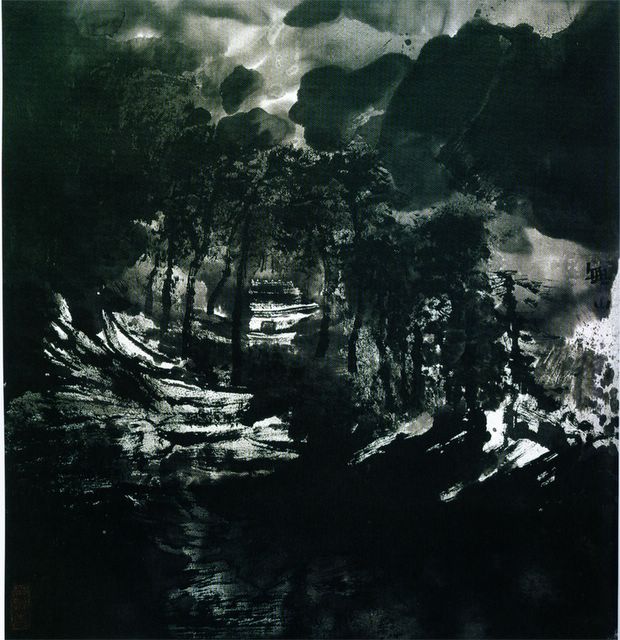
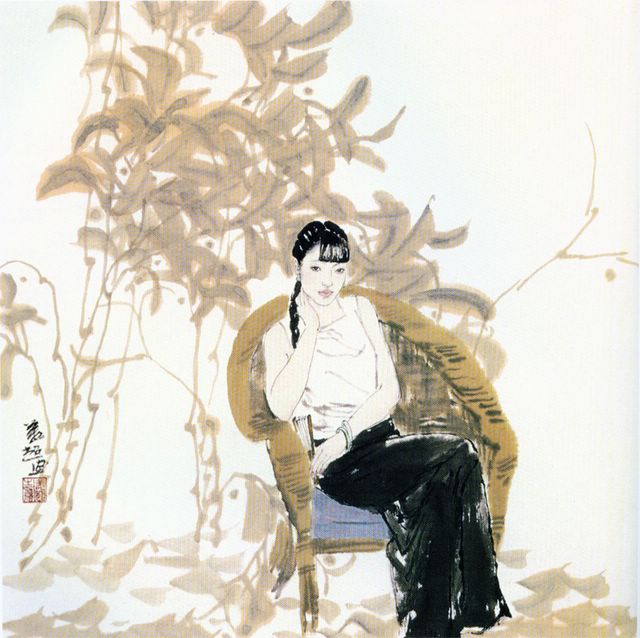
รูปเชียนภู่กันจีน

ไปสัปดาห์หนังสือแห่งชาติมา
ได้หนังสือภาพจีนมาหลายเล่ม
เลย scan รูปให้ดูกัน


 Posted by Hello


 Posted by Hello


 Posted by Hello

Related link from Roti

ลง ingres r3 บน ubuntu

เมื่อวานเข้าไป load ingres database
(ซึ่งปัจจุบันเปลี่ยนเป็น opensource แล้ว)
เอามาลงบน notebook ของตัวเอง

ตัว package ของ ingres บน linux
อยู่ในรูป rpm
จึงต้องใช้ alien ในการแปลงให้เป็น debian-package ก่อน
โดยตัวที่จำเป็นในการลงก็มี
  • ca-ingres_3.0.1-110_i386.deb -> core package
  • ca-ingres-dbms_3.0.1-110_i386.deb -> database manager
  • ca-ingres-das_3.0.1-110_i386.deb -> เพื่อให้ต่อ jdbc ได้

เนื่องจาก ingres ไม่ยอมให้ root เป็นคน start
จึงต้อง สร้าง user ingres และ group ingres เสียก่อน
จากนั้นก็ install package โดยใช้ command dpkg
จะได้ file อยู่ใน directory /opt/CA/IngresII
เนื่องจากผมยังไม่คล่อง linux มากนักเลยยังไม่รู้วิธี
ที่จะ overwrite user, group ใน debian package
ก็เลยใช้วิธี manual โดยใช้ chgrp, chown เอง

เมื่อลงเสร็จแล้วก็ให้
export II_SYSTEM=/opt/CA/IngresII
export PATH=$PATH:$II_SYSTEM/ingres/bin:$II_SYSTEM/ingres/utility
export LD_LIBRARY_PATH=$II_SYSTEM/ingres/lib

สั่ง setup database ด้วยคำสั่ง
(ใครที่ไม่เคยใช้ ingres ควรจะอ่านคู่มือ
เสียก่อน เนื่องจากมีหัวข้อที่ต้อง setup
พอสมควร)
iisudbms

สั่ง setup DAS
iisudas

เท่านี้ก็เสร็จสิ้นขบวนการ
ในการใช้งานเราจะสั่ง start server ด้วยคำสั่ง ingstart
และ stop ด้วยคำสั่ง ingstop

Related link from Roti

Thursday, March 31, 2005

Article Hibernate vs. Rails

หลังจากเริ่มเป็น Issue มาได้พักหนึ่ง
ในที่สุดก็มีคนเขียนบทความเปรียบเทียบระหว่าง
Hibernate กับ Active Record (Rails)
TheServerSide.com - Hibernate vs. Rails: The Persistence Showdown

เริ่มต้นก็เน้น Pattern ที่แตกต่างของทั้ง 2
ActiveRecord is "an object that wraps a row in a database table or view, encapsulates database access and adds domain logic on that data"[Fowler, 2003]. This means the ActiveRecord has "class" methods for finding instances, and each instance is responsible for saving, updating and deleting itself in the database. It's pretty well suited for simpler domain models, those where the tables closely resemble the domain model. It is also generally simpler then the more powerful, but complex Data Mapper pattern.
Data Mapper Pattern

The Data Mapper is "a layer of mappers that moves data between objects and a database while keeping them independent of each other and the mapper itself"[Fowler, 2003]. It moves the responsibility of persistence out of the domain object, and generally uses an identity map to maintain the relationship between the domain objects and the database. In addition, it often (and Hibernate does) use a Unit of Work (Session) to keep track of objects which are changed and make sure they persist correctly.

Related link from Roti

Wednesday, March 30, 2005

Ruby on Rails #2

ลองมาดูที่ Object Relation Mapping ก่อน
ตัว ruby on rails ใช้ Active Record

ลองดูหลักการเบื้องต้นก่อน
  • การ map เข้ากับ table
    ใช้หลักง่ายๆก็คือ ชื่อ class ในรูปเอกพจน์ map กับ ชื่อ table ในรุปพหูพจน์
    class Person < ActiveRecord::Base
    end
    class person map เข้ากับ table persons
    และ column ทุก column ใน table persons
    automatic map เป็น property ของ class Person
    Note: จะเห็นได้ว่าตัว class person ต้อง extend base class ที่ชื่อ ActiveRecord
  • การ map Relationship
    class Project < ActiveRecord::Base
    belongs_to :portfolio
    has_one :project_manager
    has_many :milestones
    has_and_belongs_to_many :categories
    end
    • belongs_to เป็นได้ทั้ง many-to-one หรือ one-to-one
      โดย primary key ของ portfolios => foreign key ของ Projects
    • has_one มีลักษณะเป็น one-to-one
      โดย primary key ของ project => foreign key ของ project_managers
    • has_many เป็น one-to-many
    • has_and_belongs_to_many เป็น many-to-many โดยต้องมี table
      หนึ่งสำหรับเก็บ pk ของทั้ง categories และ projects
      โดย default table name จะใช้ชื่อว่า categories_projects (เรียงตามลำดับอักษร)
  • Aggregate Mapping (hibernate เรียก component mapping)
    เป็นการ map attribute ตัวเดียวหรือหลายๆตัวเป็น object
    class Customer < ActiveRecord::Base
    composed_of :balance, :class_name => "Money", :mapping => %w(balance amount)
    composed_of :address, :mapping => [ %w(address_street street), %w(address_city city) ]
    end
    • customer.balance จะมี datatype เป็น Money
      โดย attribute ที่ชื่อ balance จะถูก pass เป็น
      parameter ที่ชื่อ amount ใน Money Constructor Method
    • ส่วน customer.address จะมี datatype เป็น Address
      โดยใช้ attribute address_street, address_citry
      ในการ initialize Address object

  • Validation
    class Account < ActiveRecord::Base
    validates_presence_of :subdomain, :name, :email_address, :password
    validates_uniqueness_of :subdomain
    validates_acceptance_of :terms_of_service, :on => :create
    validates_confirmation_of :password, :email_address, :on => :create
    end
    • presence_of -> Require
    • uniqueness_of -> ค่าที่ set ต้อง unique ใน table
    • acceptance_of -> case พิสดารหน่อย ไม่มีการเก็บลง table จริง
      แต่ต้องการให้มีการ pass ค่ามา
      (เห็นเขายกตัวอย่าง use case กรณี หน้าจอที่ต้อง tick accept license)
    • confirmation_of ->case พิสดารเช่นกัน เขายกตัวอย่างพวก password
      confirmation ที่ค่า 2 ค่าต้องตรงกัน
  • Self Relate RelationShip (พวกที่ structure เป็น tree)
    class Item < ActiveRecord::Base
    belongs_to :list
    acts_as_list :scope => :list
    end

  • Etc. -> Callback, Observers, Inheritance, Transaction

จะเห็นได้ว่า Powerfull เหลือเฟือเหลือใช้
เป็นทางเลือกอีกทางที่น่าสนใจ

Related link from Roti

Ruby on Rails #1

พักนี้อ่านเจอ blog ที่พูดถึง ruby on rails เยอะ
ก็เลยอยากรู้ว่าดีแค่ไหน

เท่าที่อ่านดู
ruby เป็น script language
rails เป็น Web Application framework
ดูจาก diagram ข้างล่างแล้วมี concept เป็น MVC แบบเดียวกับ struts เลย
ส่วนที่ต่างกัน ก็คงจะเป็นตรงที่ไม่ต้องเขียน Configuration file (พวก Action mapping)
แล้วก็ออกแบบมาสำหรับ web application ที่มี backend
เป็น database โดยเฉพาะ
Request cycle in Rails
การ install
  • ใช้ synaptic install ruby1.8, libzlib-ruby, libyaml-ruby, libdrd-ruby, liberb-ruby, rdoc
  • download rubygem (ทำหน้าที่เหมือน apt-get)
  • extract rubygem.tar.gz, cd เข้าไปใน directory ที่ extract สั่ง "ruby setup.rb"
  • สั่ง "gem install rails --remote"
  • สั่ง "gem install postgres-pr" (กรณีใช้ postgresql เป็น backend)


ทดสอบสร้าง Hello world
  • สั่ง "rails test" เพื่อทำการสร้าง project
    ในขั้นนี้ rail จะ generate file ให้เราจำนวนหนึ่ง
  • สามารถทดลอง run ได้โดยสั่ง "ruby script/server" ใต้ project directory แล้วใช้ browser ชี้ไปยัง http://localhost:3000/
  • สร้าง controller โดยใช้คำสั่ง "ruby script/generate controller Hello"
    จะได้ file app/controllers/Hello_controller.rb
  • edit file Hello_controller.rb
    class HelloController < ApplicationController
    def index
    render_text "hello world"
    end
    end

  • ทดลองเรียก http://localhost:3000/Hello


Note: จะเห็นได้ว่าตัว Rail จะ map ชื่อcontroller เข้ากับ url ให้โดยอัตโนมัติ
แต่ยังไม่ได้ใช้ view เข้ามา render


ทดสอบต่อ Database
เข้าไป config file "config/database.yml"
development:
adapter: postgresql
database: pphetra
host: localhost
username: pphetra
password: xxxxxxx

test:
adapter: postgresql
database: pphetra
host: localhost
username: pphetra
password: xxxxxxx

production:
adapter: postgresql
database: pphetra
host: localhost
username: pphetra
password: xxxxxxx

Note: แค่เห็นว่าเตรียมแยก develop, test, production ให้ก็รู้สึกชอบใจแล้ว
สร้าง table "Categories"
create table Categories (
id integer primary key not null default nextval('id'),
title varchar(255) not null,
description text
)

สั่ง "ruby script/generate model Category"
สั่ง "ruby script/generate controller Category"
จะได้ file app/controllers/category_controller.rb
ให้แก้เนื้อหาใน file เป็น
class CategoryController < ApplicationController
scaffold:Category
end

จากนั้นเรียก url http://localhost:3000/category
จะได้ page ที่สามารถทำ create, update, delete, list
ได้
Note: rail จะ mapping ตัว model กับ table โดย model
ต้องอยู่ในรูป เอกพจน์ ส่วนชื่อ table ต้องอยู่ในรูป พหูพจน์


Note: การ insert เข้า Postgres ยังมีปัญหาในส่วนของ generate id อยู่ ยังไม่ได้เปิดคู่มือหาจริงๆจัง

ง่ายดีเหมือนกัน แต่ใช้ assumption ที่ต้องรู้กัน เยอะพอสมควร
ส่วนที่แสดงเป็นตัวอย่างอย่างง่าย แต่ถ้าทำใช้จริง
ก็จะต้องทำส่วน view plug เข้าไป เพื่อที่จะ
customize ให้มีหน้าตาที่ user รับได้

Related link from Roti

Monday, March 28, 2005

วันนี้เห็น stack trace ของ blogger

วันนี้ post ข้อมุลแล้วเกิด exception เลยได้เห็น stack trace ของ blogger
ก็เลยใช้วิชาเดาเข้ามาช่วย

ตัว blogger ใช้ tomcat 4.x เป็น app server
ตัว web server นั้นไม่รู้ รู้แต่ว่าใช้ jk เป็นตัวแจก request ให้ tomcat
และน่าจะใช้ sticky session ด้วยเพราะมี cookie ตัวหนึ่งที่เก็บค่า serverId
(ใครที่ยังไม่เคยใช้ tomcat cluster อ่านเพิ่มเติมได้ที่นี่ link)
จากนั้นก็เข้าสู่ framework ของ google
(มีบางส่วนเป็น pyra framework) ที่วางลักษณะ
เป็น pipe chain กับ Handler chain
เท่าที่เห็นก็มี
  • IdentityCookiePipe ไม่รู้ว่าเก็บอะไร เพราะ encode ไว้ (ข้อมูลอยู่ใน cookie ที่ชื่อ I)
  • StatsPipe -> สถิติ
  • ProfileLogPipe ->น่าจะ update lastupdate, กับ logging
  • PyraJspDispatchPipe ->framework ของ Pyra ซึ่งมี handler chain
  • AuthenticatedHandler
  • ActionHandler -> ตัวนี้น่าจะเก็บ post ลง database
  • PublishHandler -> ตัวนี้น่าจะ generate cache page เก็บไว้

java.lang.OutOfMemoryError: unable to create new native thread
at java.lang.Thread.start(Native Method)
at com.pyra.blogger.Blog.publishAsync(Blog.java:1938)
at com.pyra.blogger.frontend.PublishHandler.perform(PublishHandler.java:133)
at com.google.servlet.handlers.ActionHandler.execute(ActionHandler.java:27)
at com.google.servlet.handlers.AuthenticatedHandler.execute(AuthenticatedHandler.java:106)
at com.google.servlet.pipe.HandlerDispatchPipe.invoke(HandlerDispatchPipe.java:82)
at com.pyra.blogger.frontend.PyraJspDispatchPipe.invoke(PyraJspDispatchPipe.java:71)
at com.google.servlet.pipe.ServletPipe.invokeNextPipe(ServletPipe.java:118)
at com.pyra.blogger.frontend.ProfileLogPipe.invoke(ProfileLogPipe.java:48)
at com.google.servlet.pipe.ServletPipe.invokeNextPipe(ServletPipe.java:118)
at com.google.servlet.pipe.StatsPipe.invoke(StatsPipe.java:64)
at com.google.servlet.pipe.ServletPipe.invokeNextPipe(ServletPipe.java:118)
at com.google.servlet.pipe.PendingRequestPipe.invoke(PendingRequestPipe.java:31)
at com.google.servlet.pipe.ServletPipe.invokeNextPipe(ServletPipe.java:118)
at com.google.servlet.pipe.HttpRedirectPipe.invoke(HttpRedirectPipe.java:43)
at com.google.servlet.pipe.ServletPipe.invokeNextPipe(ServletPipe.java:118)
at com.pyra.blogger.frontend.IdentityCookiePipe.invoke(IdentityCookiePipe.java:137)
at com.google.servlet.pipe.ServletPipe.invokeNextPipe(ServletPipe.java:118)
at com.google.servlet.exceptionhandling.ExceptionHandlerPipe.invoke(ExceptionHandlerPipe.java:99)
at com.google.servlet.pipe.ServletPipe.invokeNextPipe(ServletPipe.java:118)
at com.google.servlet.pipe.LocaleContextPipe.invoke(LocaleContextPipe.java:116)
at com.google.servlet.BaseServlet.doGet(BaseServlet.java:89)
at javax.servlet.http.HttpServlet.service(HttpServlet.java:740)
at javax.servlet.http.HttpServlet.service(HttpServlet.java:853)
at org.apache.catalina.core.ApplicationFilterChain.internalDoFilter(ApplicationFilterChain.java:247)
at org.apache.catalina.core.ApplicationFilterChain.doFilter(ApplicationFilterChain.java:193)
at org.apache.catalina.core.StandardWrapperValve.invoke(StandardWrapperValve.java:256)
at org.apache.catalina.core.StandardPipeline$StandardPipelineValveContext.invokeNext(StandardPipeline.java:643)
at org.apache.catalina.core.StandardPipeline.invoke(StandardPipeline.java:480)
at org.apache.catalina.core.ContainerBase.invoke(ContainerBase.java:995)
at org.apache.catalina.core.StandardContextValve.invoke(StandardContextValve.java:191)
at org.apache.catalina.core.StandardPipeline$StandardPipelineValveContext.invokeNext(StandardPipeline.java:643)
at org.apache.catalina.authenticator.AuthenticatorBase.invoke(AuthenticatorBase.java:494)
at org.apache.catalina.core.StandardPipeline$StandardPipelineValveContext.invokeNext(StandardPipeline.java:641)
at org.apache.catalina.core.StandardPipeline.invoke(StandardPipeline.java:480)
at org.apache.catalina.core.ContainerBase.invoke(ContainerBase.java:995)
at org.apache.catalina.core.StandardContext.invoke(StandardContext.java:2415)
at org.apache.catalina.core.StandardHostValve.invoke(StandardHostValve.java:180)
at org.apache.catalina.core.StandardPipeline$StandardPipelineValveContext.invokeNext(StandardPipeline.java:643)
at org.apache.catalina.valves.ErrorDispatcherValve.invoke(ErrorDispatcherValve.java:171)
at org.apache.catalina.core.StandardPipeline$StandardPipelineValveContext.invokeNext(StandardPipeline.java:641)
at org.apache.catalina.valves.ErrorReportValve.invoke(ErrorReportValve.java:172)
at org.apache.catalina.core.StandardPipeline$StandardPipelineValveContext.invokeNext(StandardPipeline.java:641)
at org.apache.catalina.core.StandardPipeline.invoke(StandardPipeline.java:480)
at org.apache.catalina.core.ContainerBase.invoke(ContainerBase.java:995)
at org.apache.catalina.core.StandardEngineValve.invoke(StandardEngineValve.java:174)
at org.apache.catalina.core.StandardPipeline$StandardPipelineValveContext.invokeNext(StandardPipeline.java:643)
at org.apache.catalina.core.StandardPipeline.invoke(StandardPipeline.java:480)
at org.apache.catalina.core.ContainerBase.invoke(ContainerBase.java:995)
at org.apache.coyote.tomcat4.CoyoteAdapter.service(CoyoteAdapter.java:223)
at org.apache.jk.server.JkCoyoteHandler.invoke(JkCoyoteHandler.java:261)
at org.apache.jk.common.HandlerRequest.invoke(HandlerRequest.java:360)
at org.apache.jk.common.ChannelSocket.invoke(ChannelSocket.java:604)
at org.apache.jk.common.ChannelSocket.processConnection(ChannelSocket.java:562)
at org.apache.jk.common.SocketConnection.runIt(ChannelSocket.java:679)
at org.apache.tomcat.util.threads.ThreadPool$ControlRunnable.run(ThreadPool.java:619)
at java.lang.Thread.run(Thread.java:534)

Related link from Roti

Transitive dependencies management

Ivy เป็น tool ตัวหนึ่งที่ช่วยจัดการ dependency library

สมมติว่า project เรา depend on project X
และ project X depend on project Y
เวลาเราเชียน build script ด้วย maven
เราต้องระบุว่า project เรา depend กับทั้ง
proejct Y และ Y

แต่สำหรับ Ivy แล้ว เราจะระบุ dependency
แค่กับ project X เท่านั้น ส่วน x จะไป
depend กับใคร ตัว Ivy จะ solve ให้เอง

feature Transitive dependencies ช่วย
ให้เราจัดการ dependency ได้ง่ายขึ้น
อย่าง project ล่าสุดของผม ใน maven ผม
ต้องระบุ dependency กับ jar ทั้งหมด
40 file แต่ถ้าเป็น Ivy, dependency ที่ต้องระบุ
จะเหลือแค่ 15 file

Related link from Roti

ตัวอย่าง Tapestry Ajax component

มีคนทดลองทำ Ajax style component อยู่ที่ XTile example
ดูตามที่เขาเขียนแล้ว ok เลย
xtile เป็น invisible component
ทำหน้าที่เป็นตัว call xmlhttprequest
เข้าไปยัง Page Listener

ชอบที่ call ตรงเข้า page listener เลย
ทำให้ source code ไม่กระจัดกระจาย

Related link from Roti

Saturday, March 26, 2005

มี java มานานแล้ว ในที่สุดก็มี bangkok

opensource project ตัวนี้มี code name ว่า bangkok
ตอนแรกนึกว่าคนไทยเขียน แต่ check ดูแล้วไม่ใช่แฮะ

Related link from Roti

Friday, March 25, 2005

config xterm function key

ช่วงนี้มีความจำเป็นต้องกลับไปช่วย maintain ระบบเก่า
ที่ต้องใช้ terminal emulator ในการ coding
แต่มีปัญหาว่า function key ที่ xterm map ไม่ตรง

ก็เลยเขียน shell script ง่ายๆสำหรับการ override function key
xterm  -title "SSO" -sb -sl 1200   -geo 80x24   \              
-cr red -xrm \
"XTerm*vt100.translations: #override
Shift F1: string(0x1b) string("Wa")
Shift F2: string(0x1b) string("Wb")
Shift F3: string(0x1b) string("Wc")
Shift F4: string(0x1b) string("Wd")
Shift F5: string(0x1b) string("We")
....
~Shift F1: string(0x1b) string("WA")
~Shift F2: string(0x1b) string("WB")
~Shift F3: string(0x1b) string("WC")
~Shift F4: string(0x1b) string("WD")
....
-e telnet 192.10.1.1 &

อ่านเพิ่มเติมได้ที่นี่ xterm Faq

Related link from Roti

Thursday, March 24, 2005

Joda Bean

อยู่ที่ Joda
หลายคนที่เคยเขียน UI คงเคยรู้ว่ามีแนวทางในการ
ส่ง business object ไปยัง UI layer อยู่ 2 พวกคือ
  • พวกที่นิยม Type Safe พวกนี้จะใช้ Java Bean
  • พวกที่นิยม Generic พวกนี้จะใช้ HashMap

จุดเด่นของพวก generic ก็คือง่ายต่อการ binding เข้ากับ UI component
ส่วนข้อเสียก็คือการเปิดโอกาสให้เกิด bug หรือ runtime error ได้ง่ายขึ้น

ตัว Joda Bean จะเป็นลูกผสมของ 2 พวกนี้
คือใช้ hashMap เป็น base class แต่ก็สามารถ
set property ในลักษณะ Type Safe ได้เช่นกัน
การเขียน Joda Bean จะเชียนดังนี้
public interface Person extends Bean {
StringProperty surname();
String getSurname();
void setSurname(String surname);
}

เราเพียงแต่เขียน interface
พอถึงเวลาใช้ ก็เพียงแต่
Person person = (Person) JodaFactory.create(Person.class);

Joda จะใช้ Java 1.3 Proxy ในการสร้าง class person ให้เรา

การนำไปใช้
กรณีที่เราต้องการ binding เข้ากับ swing JTextField
JTextField textField = new JTextField();
Person person = (Person) JodaFactory.create(Person.class);
SwingBinder binder = new SwingBinder();
binder.bind( textField, person.surname() );

Note: Joda binding ยังไม่ support พวก combobox, table component

นอกจากนี้ยังสามารถใช้ XPath ในการ access ได้ด้วย
XPath xpath = new XPath("address[2]/town/text()");
Profile profile = (Profile) JodaFactory.create(Profile.class);
String str = (String) xpath.selectSingleNode(profile);

Related link from Roti

color schema

สำหรับผู้ที่ขี้เกียจเปิด color schema book
หรือ programmer ผู้ที่มีปัญหาในการเลือกสี
color schema

Related link from Roti

IE send request for PDF twice

project ที่แล้วมี PDF report ที่เขียน jasper ไป 74 ตัว
ไม่เห็น issue นี้เลย (หรือว่า server จะเร็วจัดจนไม่เกิด
performance drop)
http://www.mail-archive.com/user@struts.apache.org/msg23445.html
ต้องกลับไปดู log ใหม่แล้ว

Related link from Roti

tomcat trimspace

ได้ความรู้ใหม่มา
ปกติเวลาเรา view html source
จาก page ที่สร้างจาก jsp
เราจะเห็นบรรทัดว่างๆอยู่ทั่วไปหมด
ใน tomcat 5.5.x เราสามารถ config ไม่ให้
มี whitespace พวกนี้โดย
 <init-param>
<param-name>trimSpaces</param-name>
<param-value>true</param-value>
</init-param>

Related link from Roti

toogle

ใครเคยใช้ search engine ตัวนี้หรือยังครับ
http://www.c6.org/toogle/

Related link from Roti

Maven Eclipse Plugin

ใครที่เคยใช้ java คงจะเคยใช้ ant มากันแล้ว
ข้อเสียของ ant (จริงๆก็ไม่ใช่ข้อเสียหรอก) ก็คือ
ไม่ว่าจะเขียนกี่ project
file build.xml ก็หน้าตาอีหรอบเดิมทุกที
(คนที่เคยเขียน ant คงรู้ว่า วิธีการเขียน
ant ที่เร็วที่สุดก็คือการ copy, paste จาก
build file เก่า)
จนมีคนคิดว่า เอ๊ะทำไมเราต้องมาเขียน
อะไรซ้ำไปซ้ำมา ก็เลยเกิดเป็น maven
ขึ้นมา

การเขียน maven ถ้าเป็น project ธรรมดา
ก็เพียงเขียนแต่ project.xml ซึ่งเป็น descriptor
อธิบายรายละเอียดของ project
ซึ่ง key สำคัญตัวหนึ่งที่ maven จัดการให้ก็คือ
library dependency ซึ่ง maven จะจัดการหา
jar file ตาม version ที่เราระบุให้
โดย mavenจะ maintain jar file นั้นไว้ใน
local repository ของตัวเอง กรณีทีในเครื่อง
local ไม่มี file นั้น ก็จะทำการ download
จาก remote repository (ผมชอบ feature นี้มาก
เพราะแทนที่เราจะมี jar file ที่ใช้บ่อยๆอย่าง log4j.jar
กระจายอยู่ในทุก project ถ้าใช้ maven ก็จะ
เกิดการ share jar ไว้ที่ repository ที่เดียว)

ที่นี้ถ้าเราต้องการใช้ eclipse ร่วมกับ
maven , maven ก็มี plugin อยู่ตัว
ที่ช่วยในการ generate .project กับ
.classpath ให้เรา (เป็น file ที่ eclipse
ใช้ในขบวนการ build) ทำให้เรา
เปิด eclipse มา edit source ได้เลย
ไม่ต้องไปเสียเวลา add jar file เข้ามา
ใน build path อีก

การใช้ก็ไม่ยากอะไร
เขียน project .xml เสร็จ ก็สั่ง
maven eclipse

ตัว file .classpath ที่ maven สร้างให้จะสร้างตามนี้
1. the build source directory
2. the build unit test source directory
3. the JRE being used
4. the appropriate version of JUnit
5. each Maven project dependency
6. an output directory for compiled code: target\classes
7. any .zip source archives

ตัวอย่าง .classpath ที่ maven gen ให้
<?xml version="1.0" encoding="UTF-8"?>
<classpath>
<classpathentry excluding="" kind="src" path="src/main/java">
</classpathentry>
<classpathentry excluding="" including="" kind="src" path="src/main/resources">
</classpathentry>
<classpathentry output="target/test-classes" kind="src" path="src/test/java">
</classpathentry>
<classpathentry kind="var" path="MAVEN_REPO/junit/jars/junit-3.8.1.jar">
</classpathentry>
<classpathentry kind="con" path="org.eclipse.jdt.launching.JRE_CONTAINER">
</classpathentry>
<classpathentry kind="var" path="MAVEN_REPO/log4j/jars/log4j-1.2.8.jar">
</classpathentry>
<classpathentry kind="output" path="target/classes">
</classpathentry>
</classpath>

จะสังเกตุเห็นว่า มี variable อยู่ตัวที่ชื่อ MAVEN_REPO (maven repository location)
ซึ่งเราต้องเข้าไป manual add ใน eclipse เอง
หรือไม่ก็สั่ง
maven eclipse:add-maven-repo 

แต่การสั่งแบบนี้ต้องมีการ set ค่า ${maven.eclipse.workspace}
(eclipse workspace location)
ไว้ใน project.properties ด้วย

อ่านเพิ่มเติม

Related link from Roti

Wednesday, March 23, 2005

ปัญหา encoding ของ eclipse

ช่วงนี้อยู่ระหว่างการย้ายสภาพแวดล้อมการทำงาน
จาก window ไปเป็น linux (ubuntu)
ก็เลยมี issue ให้จัดการเยอะหน่อย
ล่าสุดก็เป็นกรณี eclipse editor preference ไม่มี encoding thai ให้เลือก
ทดลองสั่ง LANG=th_TH ก็พบ warning ตอน start eclipse
(process:5042): Gdk-WARNING **: locale not supported by C library

ก็เลยต้อง reconfig locales ใหม่ให้ถูกต้อง
sudo dpkg-reconfigure locales

Related link from Roti

ศึกษา ADHD case

ตอนนี้กำลังง่วนอยู่กับการศึกษา super-computer ที่บ้ายอยู่
กำลังหาหนังสืออ่านกรณี Attention Deficit Hyperactivity Disorder (ADHD)
กับกรณี Autistic Disorder
เพื่อไว้กรณี super-comp ของเราจะเข้าข่ายนี้

ปล. ใครยังไม่มีลูก ก็ลองหาลูกสักคนดูนะ
โปรแกรมยากมาก
debugger ก็ไม่มีให้ด้วย

Related link from Roti

Friday, March 18, 2005

จังหวัด-อำเภอ Component in Tapestry

เมื่อก่อนผมใช้ Struts เป็น Framework สำหรับ Web Application
ซึ่งก็ใช้ได้ดีทีเดียวแหล่ะ แต่มีอยู่จุดหนึ่งที่รู้สึกว่าเป็นจุดอ่อน
ของ struts ก็คือประเด็นเรื่อง reuse UI component
จริงๆอยู่เราสามารถทำ custom taglib ในส่วนนี้เองได้
แต่มันก็ยังขาดๆเกินๆอยู่

จนมาได้ลองใช้ Tapestry จึงได้พบคำตอบในส่วน UI Component
Tapestry เป็น Framework ที่มีรากฐานอยู่บน
Component เราจึงสามารถ reuse component
ต่างๆได้เต็มเม็ดเต็มหน่วย (แน่นอนมีสิ่งที่ต้องแลกเปลี่ยนเหมือนกัน)

framework ของ Tapestry เปิดโอกาสให้เรา
ได้ทำ binding ทั้ง 2 ทาง คือ ทั้งขา Request และ
ขา Response ซึ่งต่างจาก Taglib ที่ทำ binding
เฉพาะในส่วนการ Render อย่างเดียว (เมื่อ user post กลับมา
ตัว taglib จะไม่ได้ถูกเรียกใช้ แต่กรณีถ้าเป็น tapestry
ตัว component จะถูกเรียกใช้ ซึ่งในการเรียกใช้ครั้งนี้
ไม่ได้เพื่อทำการ render แต่เพื่อการ parse request parameter)

ลองมาดูกันว่า กรณีที่เป็น Tapestry Component แล้ว
เราต้องทำอะไรบ้าง

อำเภอ จังหวัด component
หลายคนคงเคยทำ ui ในส่วน "ที่อยู่" ที่ให้ user ป้อนมาแล้ว
หลักการง่ายๆก็คือ มี list box จังหวัด กับ list box อำเภอ
เมื่อ user เลือกจังหวัด list box ของอำเภอก็จะเปลี่ยน choice ตาม
การเปลี่ยนค่านี้กำหนดให้ใช้ XmlHttpRequest เพื่อไม่ให้เกิดการ
update page ทั้งหมด
โดยผมจะลองแสดงให้ดูว่าถ้าเป็น tapestry component
แล้วจะต้องทำอย่างไร

กำหนดให้ชื่อ component ว่า ZoneComponent

Component Specification
ตั้งชื่อว่า ZoneComponent.jwc มีหน้าตาดังนี้
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE component-specification
PUBLIC "-//Apache Software Foundation//Tapestry Specification 3.0//EN"
"http://jakarta.apache.org/tapestry/dtd/Tapestry_3_0.dtd">
<!-- generated by Spindle, http://spindle.sourceforge.net -->

<component-specification
class="sdf.web.comps.ZoneProvince"
allow-body="no" allow-informal-parameters="yes">

<parameter name="province" direction="form"
type="sdf.domain.Province" required="yes"/>
<parameter name="zone" direction="form"
type="sdf.domain.Zone" required="yes"/>
<parameter name="serviceUrl" direction="in"
type="java.lang.String" required="yes"/>
<parameter name="serviceMethod" direction="in"
type="java.lang.String" required="yes"/>
<parameter name="disabled" direction="in"
type="boolean" required="no"/>

<property-specification name="name"
type="java.lang.String"/>
<property-specification name="form"
type="org.apache.tapestry.IForm"/>

<private-asset name="script"
resource-path="/sdf/web/comps/ZoneProvince.script"/>
</component-specification>

วัตถุประสงค์หลักๆของ component-spec ก็คือ
การกำหนดว่า component เรามี parameter อะไรให้ set ได้บ้าง
(คนที่ set ก็คือ คนที่เอา component เราไปร้อยเข้าเป็น Application)
ตัวที่น่าสนใจก็คือ parameter name="province"
type="sdf.domain.Province" -> อันนี้คือ business object ของจังหวัด
direction="form" -> ระบุว่าเป็น bi-direction ใช้ทั้งกรณี Request และ Response
ส่วนตัว serviceUrl, serviceMethod เป็นตัวกำหนดค่า url ของ service
ที่ให้บริการกรณีที่ user click เปลี่ยนจังหวัดและต้องการนำค่า อำเภอใหม่
ไป update "อำเภอ listbox" ค่าพวกนี้มี Direction เป็น "in"
เนื่องจากเป็นพวก readonly ไม่มีการ post back กลับมาจาก user

JavaScript Template
เนื่องจากเราใช้ XMLHttpRequest เป็น channel ในการ update listbox
ดังนั้นต้องมีการใช้ javascript เข้ามาช่วย
Tapestry วางแนวทางการ embed javascript ไว้แล้วโดย
ให้เราใช้ Javascript template ในการ define javascript
(เนื่องจาก component เราจะถูกประกอบทีหลัง ดังนั้นจะมี
ค่าบางค่าที่ยังไม่รู้ว่าจะเป็นอะไร อย่างเช่นชื่อของ component
จึงต้องออกแบบให้เป็น template
เมื่อรู้ค่าที่แน่นอนแล้วจึงจะสามารถสร้างออกมาเป็น javascript
ที่ใช้งานได้จริงๆ การทำเช่นนี้ทำให้ไม่เกิดปัญหา naming comflict
กรณีที่เรามี instance ของ component มากกว่า 1 instance ใน
page เดียวกัน เช่นกรณีที่อยู่ที่ใน 1 หน้าอาจมีทั้ง ที่ทำงาน ที่ติดต่อ สถานที่เกิด)

<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE script PUBLIC
"-//Apache Software Foundation//Tapestry Script Specification 3.0//EN"
"http://jakarta.apache.org/tapestry/dtd/Script_3_0.dtd">

<script>
<include-script resource-path="jsrsClient.js"/>

<input-symbol key="provinceName"
class="java.lang.String" required="yes"/>
<input-symbol key="zoneName"
class="java.lang.String" required="yes"/>
<input-symbol key="formName"
class="java.lang.String" required="yes"/>
<input-symbol key="serviceUrl"
class="java.lang.String" required="yes"/>
<input-symbol key="serviceMethod"
class="java.lang.String" required="yes"/>
<input-symbol key="scriptChangedMethod"
class="java.lang.String" required="yes"/>

<let key="populateZone" unique="yes">
populateZone_${zoneName}
</let>


<body>
function clearDropDown (selField)
{
while (selField.options.length > 0)
selField.options[0] = null;
}

function ${populateZone} (valueTextStr)
{
var selField = document.${formName}.${zoneName};
clearDropDown(selField);

// create an array of each item for the dropdown
var aPairs = valueTextStr.split(";");
if (valueTextStr.substr(valueTextStr.length - 1) == ';') {
aPairs[aPairs.length - 1] = null;
aPairs.length--;
}
// Fill 'er up
for (var i=0; i <; aPairs.length; i++) {
// each item is a "value,name" pair
aValueText = aPairs[i].split(",");
oItem = new Option;
oItem.value = aValueText[0];
oItem.text = aValueText[1];
selField.options[selField.options.length] = oItem;
}
selField.options.selectedIndex = 0;
}

function ${scriptChangedMethod}()
{
jsrsExecute("${serviceUrl}", ${populateZone},
"${serviceMethod}",
document.${formName}.${provinceName}
.options[document.${formName}
.${provinceName}.selectedIndex].value);
}
</body>

จะเห็นว่ามี element หลักๆ อยู่ 3 กลุ่ม
  • <include-script> ตัวนี้จะเป็นตัวบอกว่ามี js library ตัวไหนที่ต้อง load มาบ้าง
    กรณีของเราเราใช้ jsrsClient.js

  • <input-symbol> ใช้กำหนดค่าตัวแปรที่ต้องถูก pass เข้ามา ณ ตอนที่
    generate javascript

  • <body> เป็น script หลักในการทำงาน
    จะเห็นได้ว่าตัวแปรที่ยังไม่รู้ค่าจะอยู่ในรูป ${xxxxx}


Component Class
ตรงนี้จะเขียน code หลักในส่วนของการ render และ
การ parse Request parameter เมื่อ user post form กลับเข้ามา

  • กรณีการ render component จะหน้าตาประมาณนี้

  Body body = Body.get(cycle);

if (body == null)
throw new ApplicationRuntimeException(
Tapestry.format("must-be-contained-by-body",
"ZoneProvince"),
this,
null,
null);

Map symbols = new HashMap();

symbols.put(SYM_PROVINCE_NAME, provinceName);
symbols.put(SYM_ZONE_NAME, zoneName);
symbols.put(SYM_FORMNAME, form.getName());
symbols.put(SYM_SERVICE_METHOD, getServiceMethod());
symbols.put(SYM_SERVICE_URL, getServiceUrl());
symbols.put(SYM_SCRIPT_CHANGED_METHOD, scriptChangedMethod);

// generate ส่วน JavaScript
_script.execute(cycle, body, symbols);


writer.begin("select");
writer.attribute("name", zoneName);
renderInformalParameters(writer, cycle);

String provCode = "10"; // default to bangkok
if (getProvince() != null) {
provCode = getProvince().getCode();
}
String zoneCode = null;
if (getZone() != null) {
zoneCode = getZone().getCode();
}

// render zone list
List list = svr.findZone(provCode,
IConstants.ORDER_BY_NAME);
for (Iterator iter = list.iterator(); iter.hasNext();) {
Zone zone = (Zone) iter.next();
writer.begin("option");
writer.attribute("value", zone.getCode());
if (zoneCode != null &&
zone.getCode().equals(zoneCode)) {
writer.attribute("selected", true);
}
writer.closeTag(); // close option tag
writer.printRaw(zone.getName());
writer.end("option");
}
writer.end("select");

// render province list
writer.begin("select");
writer.attribute("name", provinceName);
writer.attribute("onchange",
"javascript:" + scriptChangedMethod + "()");
renderInformalParameters(writer, cycle);

list = svr.findAllProvince(IConstants.ORDER_BY_NAME);
for (Iterator iter = list.iterator(); iter.hasNext();) {
Province province = (Province) iter.next();
writer.begin("option");
writer.attribute("value", province.getCode());
if (province.getCode().equals(provCode)) {
writer.attribute("selected", true);
}
writer.closeTag(); // close option tag
writer.printRaw(province.getName());
writer.end("option");
}

writer.end("select");


  • กรณีการ parse parameter เมื่อมีการ post กลับมา

  String provinceCode = cycle.getRequestContext()
.getParameter(provinceName);
String zoneCode = cycle.getRequestContext()
.getParameter(zoneName);

if (Tapestry.isBlank(provinceCode)) {
return;
} else {
Province value = svr.getProvince(provinceCode);
setProvince(value);
}

if (Tapestry.isBlank(zoneCode)) {
return;
} else {
Zone value = svr.getZone(zoneCode);
setZone(value);
}

มี code หลักๆ เท่านี้ก็ได้ component สำหรับ reuse ใช้ใน Application
เราแล้ว คราวนี้ไม่ว่าจะเป็น ที่อยู่, ที่ติดต่อ, บ้านเกิด, ที่ทำงาน ก็สามารถ
ใช้ component ชุดเดียวกันได้

ตัวอย่างเวลานำไปใช้
  • html file

    <td valign="top" class="label"><div 
align="right">ที่อยู่ :</div></td>
<td><table width="100%" border="0">
<tr>
<td><input jwcid="addr1@ValidField"
value="ognl:firm.address.addr1"
displayName="ที่อยู่"
validator="ognl:beans.addr1RequireValidator"
type="text" size="50" maxlength="50"/></td>
</tr>
<tr>
<td><input jwcid="@TextField"
value="ognl:firm.address.addr2"
type="text"
size="50"
maxlength="50"/></td>
</tr>
<tr>
<td><span jwcid="zoneProvince">
zone components
</span></td>
</tr>
</table></td>

จะเห็นว่าใช้แค่ jwcid="zoneProvince" เป็นการบอกว่า
ตรงนี้เป็น component ที่มีชื่อ instance ว่า zoneProvince
ซึ่งจะมีการ declare ไว้ใน Page Specification อีกที
  • Page Specification file

    <component id="zoneProvince" type="ZoneProvince">
<binding name="province"
expression="firm.address.province"/>
<binding name="zone"
expression="firm.address.zone"/>
<static-binding name="serviceUrl"
value="/sdf/zone"/>
<static-binding name="serviceMethod"
value="getZone"/>
</component>

จะเห็นว่าตรงนี้จะมีการ binding parameter เข้ากับ Page Object
โดยระบุตรง expression คำว่า "firm.address.province" หมายถึง
ให้ไปเอา object provice มาโดยใช้คำสั่ง
getFirm().getAdress().getProvince() กับ Page Object

Note: ต้วอย่างการนำไปใช้ที่แสดงให้ดู
เป็นการเขียนแบบ formal ถ้าเป็นแบบ informal code
จะกระทัดรัดกว่านี้ แต่จะอ่านยากกว่าถ้าไม่เคยใช้
tapestry มาก่อน


ข้อมูลเพิ่มเติม

Related link from Roti

SpringDoc

ช่วย Generate Document ของ Spring Context Xml File
Spring Doc
เยี่ยมมาก ช่วยให้เรา visualize โครงสร้างได้ชัดขึ้น

Related link from Roti

XMLHttpRequest & Ajax Working Examples

XMLHttpRequest & Ajax Working Examples - Links and Resources, Fiftyfoureleven.com

Related link from Roti

Wednesday, March 16, 2005

Ruby Quiz

ชอบวิธีที่เขาอธิบายโจทย์
และเฉลย อธิบายชัดเจนดี
เขียน ruby ไม่เป็นก็ดูได้ครับ (ผมก็เขียนไม่เป็น)
Ruby Quiz

Related link from Roti

ทดลอง Blogger API

ขอพักส่วน UI ของ LogAnalyzer ไว้ก่อน
เมื่อวานได้ปั่น version java swing ให้พอใช้งานได้เสร็จไปแล้ว
ไว้มีเวลาแล้วจะทดลองในส่วนของ jface, swt ต่อ

ย้อนกลับไปเมือวันอาทิตย์ได้ทดลองใช้ blogger api ดู
สืบเนื่องจากไม่ค่อยถูกใจ editor ที่ใช้ในปัจจุบัน
ก็เลยคิดจะหาทาง post เอง

เริ่มจากเข้าไปที่หน้า http://www.blogger.com/developers/
จะเห็นว่ามี api ให้เลือกอยู่ 2 ตัวก็คือ
  • Blogger API 1.0
  • Atom API


Blogger API
API ตัวนี้ใช้ XML-RPC ก็เลยไป load เอา
Apache XML-RPC มาทดลองใช้
เขียน Code แค่นี้ก็ post ได้แล้ว
  XmlRpcClient client = new XmlRpcClient
("http://plant.blogger.com/api/RPC2");
Vector args = new Vector();
args.add("0123456789ABCDEF"); // APP ID ปัจจุบัน blogger ไม่สนใจค่านี้แล้ว
args.add("11409654"); // blog id
args.add("pphetra"); // user id
args.add("***********"); // password
args.add("content .........");
args.add(Boolean.TRUE); // publish
try {
client.execute("blogger.newPost", args);
System.out.println(obj.getClass().getName());
} catch (Exception e) {
e.printStackTrace();
}

ง่ายดายมาก แต่ก็เจอปัญหาอยู่ 2 จุด
จุดที่ 1 คือ ไม่มี param blog title ให้ใช้
ค้นหาเอกสารพบว่า มีส่วนขยายที่ชื่อ MetaWebLog
ให้ใช้ (ไม่ได้ทดลองเพราะยังแก้ปัญหาจุดที่ 2 ไม่ได้)
จุดที่ 2 อันนี้ร้ายแรงหน่อย ก็คือ ส่งภาษาไทยไม่ได้
พอทดลองส่งภาษาไทยพบปัญหา
java.io.IOException: Invalid character data corresponding to XML entity ก
at org.apache.xmlrpc.XmlRpcClient$Worker.execute(XmlRpcClient.java:444)
at org.apache.xmlrpc.XmlRpcClient.execute(XmlRpcClient.java:163)

ก็เลยไปดู source code พบว่า
default:
if (c < 0x20 || c > 0xff)
{
// Though the XML-RPC spec allows any ASCII
// characters except '<' and '&', the XML spec
// does not allow this range of characters,
// resulting in a parse error from most XML
// parsers.
throw new XmlRpcClientException("Invalid character data " +
"corresponding to XML entity &#" +
String.valueOf((int) c) + ';', null);
}
else
{
write(c);
}
}

ก็เลยสงสัยว่า แล้วพวกประเทศอื่นๆไม่มีใครเขาใช้ apache xml-rpc เลยหรือ
ก็เลยเข้าไปค้น issue ดูพบ
http://issues.apache.org/jira/browse/XMLRPC-45
ค่อยรู้สึกว่ามีเพื่อนหน่อย
จากนั้นก็เลยทำการ comment ประโยคที่ตรวจสอบออก
แล้วก็ build xml-rpc เอง
คราวนี้ส่งได้แล้ว แต่ฟัง blogger รับแล้วแสดงผลเป็น ?????
ก็เลยหมดปัญญา เพราะไม่รู้ว่าโปรแกรมฝั่งเขามีขบวนการ decode
อะไรแบบไหน ก็เปลี่ยนมาใช้ Atom api

Atom API
ตาม link ข้างบนไปจตถึงหน้านี้ http://atomenabled.org/developers/api/
เห็นมี WSDL ก็เลยกะว่าจะใช้ Apache AXIS
Generate Client code ให้
ทำการสั่ง wsdl2java พบปัญหา
C:\temp>java org.apache.axis.wsdl.WSDL2Java
http://atomenabled.org/developers/api/AtomAPI.wsdl
java.util.NoSuchElementException
at java.util.HashMap$HashIterator.nextEntry(HashMap.java:785)
at java.util.HashMap$ValueIterator.next(HashMap.java:812)

ค้นใน net พบ issue AXIS-249
ตกลงเป็นปัญหาที่ axis ไม่สามารถ generate operation ที่ไม่มี parameter ได้
(ดูแล้ว axis ก็ถูกนะจะมี web service ที่ไหน ที่ไม่ต้อง pass param ไปบ้าง)
คราวนี้ขี้เกียจ build axis ใหม่ ก็เลยใช้วิธี load เอา wsdl มาแก้ไข
โดยลบส่วน operation ที่ไม่มี parameter ออก
คราวนี้สามารถ generate source code ออกมาได้แล้ว
ทดลอง เขียนโปรแกรมดู
  AtomAPILocator locate = new AtomAPILocator();
AtomAPISoap api = locate.getAtomAPISoap(new
URL("http://www.blogger.com/atom/11409654"));
ContentType ct = new ContentType();
ct.setMode(ContentTypeMode.xml);
ct.setAny(.... (source code ตรงนี้แก้ไปแล้วเลยจำไม่ได้));

EntryType entry = new EntryType();

entry.setTitle("hello test");
entry.setIssued(new GregorianCalendar());
entry.setContent(new ContentType[] {ct});
api.POST(entry);

ส่งครั้งแรกไม่ผ่าน ติดปัญหา authenticate
ก็เลยไปแก้ source code ที่ axis gen ให้ เพิ่มส่วน
set user กับ password ลงไป
  org.apache.axis.client.Call _call = createCall();
_call.setUsername("pphetra");
_call.setPassword("*********");

คราวนี้ผ่าน step แรกแต่พบปัญหาว่ามันฟ้องเรื่อง
Malformed XML. Mode indicated was 'xml' but data was not xml

ก็เลยต้อง start tcpmon เพื่อดูว่า protocol ที่ส่งไปมีหน้าตาเป็นอย่างไร
ได้ความว่ามันส่งส่วน post แบบนี้
<?xml version="1.0" encoding="UTF-8"?>
<soapenv:Envelope xmlns:soapenv="http://schemas.xmlsoap.org/soap/envelope/" xmlns:xsd="http://www.w3.org/2001/XMLSchema" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance">
<soapenv:Body>
<POST xmlns="http://schemas.xmlsoap.org/wsdl/http/">
<ns1:entry xmlns:ns1="http://purl.org/atom/ns#">
<ns1:title>hello test</ns1:title>
<ns1:generator xsi:nil="true"/>
<ns1:issued>2548-03-16T09:22:18.640Z</ns1:issued>
<ns1:content></ns1:content>
</ns1:entry>
</POST>
</soapenv:Body>
</soapenv:Envelope>

ก็เลยสงสัยว่าตัว content มันหาย
ก็เลยไป hack ส่วน code ที่ axis generate ออกมา
เขียนส่วน serializable ของ content เอง
ในที่สุดก็ได้ content ออกมา
แต่พอ run แล้วก็ยังได้ message เหมือนเดิม

ชักหมดแรง ลองมาหลายวิธีจนเหนื่อยแล้ว
(หมกมุ่นจนภรรยาเกิดอาการงอน)
พักไว้ก่อนดีกว่า

ปล. วันนี้ค้นเจอแล้วว่า format ที่ถูกเป็นอย่างไร
ตัวเอกสารอยู่ที่ atom-docs
ไม่เห็นมี SOAP แปะเลย แล้วมันจะมี WSDL ไว้ทำหยัง
ไว้ให้แฟนอารมณ์ดีแล้วค่อยลองใหม่

POST /atom/3187374 HTTP/1.1
Host: www.blogger.com
Authorization: BASIC c3RldmVqOm5vdGFyZWFscGFzc3dvcmQ=

<?xml version="1.0" encoding="UTF-8" standalone="yes"?>
<entry xmlns="http://purl.org/atom/ns#">
<title mode="escaped" type="text/plain">atom test</title>
<issued>2004-04-12T06:07:20Z</issued>
<generator url="http://www.yoursitesurlhere.com">Your client's name here.</generator>
<content type="application/xhtml+xml">
<div xmlns="http://www.w3.org/1999/xhtml">Testing the Atom API</div>
</content>
</entry>

Related link from Roti

Tuesday, March 15, 2005

Java Programming Notes

วันนี้เขียน swing มีบางเรื่องเป็นเรื่องเล็กน้อยที่จำไม่ได้
ไปค้นเจอใน note นี้
Java Programming Notes
ีช่วยเตือนความจำได้ดี

Idea
ถ้า load มาแล้วเอา lucene มาช่วยทำ index
integrate เข้าเป็น plugin ของ eclipse

Related link from Roti

dojo.io.bind(): baking usability into XMLHTTP

dojo.io.bind(): baking usability into XMLHTTP

Related link from Roti

Monday, March 14, 2005

Project Log Analyzer #2

เมื่อวาน implement ส่วน Log Parser เสร็จไปแล้ว
วันนี้ก็จะเริ่มทำส่วน Index Repository กับส่วน Query บ้าง

Index Repository
Index Repository ก็คือ พื้นที่ที่เก็บ mapping
ระหว่าง label กับ rownumber ของ log file

ในส่วนนี้เราจะนำเอา class BitSet มาใช้
implement ง่ายๆ ดังนี้
Map labelMap;
public void addLabel(String labelId,
String labelValue, int rowNumber) {
BitSet bs = null;
if (labelMap.containsKey(labelValue)) {
bs = (BitSet) labelMap.get(labelValue);
} else {
bs = new BitSet();
labelMap.put(labelValue, bs);
}
bs.set(rowNumber);
}

Query
แยกทำเป็น 2 ส่วนคือ Basic Search กับ Advance Search

Basic Search
เป็นการค้นหาแบบง่่ายๆ ตรงไปตรงมา
user ใส่ข้อมูลในลักษณะเป็น "word (word)*"
เช่น
"sompop" -> ค้นหา line ที่มี label = sompop
"sompop uc2110" -> ค้นหา line ที่มี label = sompop และ = uc2110
basic search implement ได้ง่ายๆดังนี้
public int[] search(String[] labelValues) {
BitSet bs = null;
for (int i = 0; i < labelValues.length; i++) {
BitSet tmp = (BitSet) repo.labelMap.get
(labelValues[i]);
if (tmp != null) {
if (bs == null) {
bs = (BitSet) tmp.clone();
} else {
bs.and(tmp);
}
}
}
return converToArray(bs);
}

Advance Search
user สามารถใส่ข้อมูลในลักษณะ logical expression ได้เช่น
"sompop & (piya | uc2110)"
การ implement เลือกใช้ Antlr มาทำเป็น parser
เนื่องจากรู้สึกลืมๆไปหมดแล้ว เลยอยากทบทวน

Lexer
มี spec ดังนี้
class AdvQryLexer extends Lexer;
options {
k = 2;
}

AND : '&';
OR : '|';
LPAREN : '(';
RPAREN : ')';
NEGATE : '!';
SEMI : ';';

WS : ( ' '
| '\t'
| "\r\n"
| '\n'
) {$setType(Token.SKIP);}
;

protected
LETTER
: '\u0024' |
'\u0041'..'\u005a' |
'\u005f' |
'\u0061'..'\u007a' |
'\u00c0'..'\u00d6' |
'\u00d8'..'\u00f6' |
'\u00f8'..'\u00ff' |
'\u0100'..'\u1fff' |
'\u3040'..'\u318f' |
'\u3300'..'\u337f' |
'\u3400'..'\u3d2d' |
'\u4e00'..'\u9fff' |
'\uf900'..'\ufaff'
;

TERM : (LETTER|('0'..'9'))+
;

TERM -> คือ String ที่ใช้ในการ search ประกอบด้วย
ตัวอักษร (สังเกตุว่ามี unicode ด้วย) หรือ ตัวเลข
SEMI -> ใส่เพิ่มเข้ามาโดยโปรแกรมเพื่อให้รู้ว่าเป็นตัวปิดท้าย syntax
เป็นตัวปิดท้าย
{$setType(Token.SKIP);}
-> เป็นการบอก lexer ไม่ต้องส่ง token นั้นไปให้ parser

Parser
class AdvQryParser extends Parser;
options {
k = 2;
buildAST = true;
}
search : expression SEMI!
;

primitive : TERM
| LPAREN! expression RPAREN!
;

unaryExpression
: (NEGATE^)?
primitive
;

logicalExpression
: unaryExpression
((AND^ | OR^) unaryExpression
)*
;

expression : logicalExpression
;

พวกที่เป็นตัวใหญ่หมด ก็คือ token ที่ define ไว้ใน lexer
ส่วนเครื่องหมาย "^" หมายถึงว่าต้องการให้ node นั้นเป็น root node
ใน AST ที่ generate ขึ้นมา
เครื่องหมาย "!" ที่ตามหลังก็คือไม่ต้องการให้รวม token นั้นเข้าไปใน AST
ในการเขียน parser เราต้องกำหนด rule ที่เป็นจุดท้ายเข้าหลัก
ของการ parse ในทีนี้ก้คือ "search"

Tree Parser
ผลลัพท์จากการ parse เราจะได้ AST ออกมา
ขั้นต่อไปก็คือการท่อง AST เพื่อที่จะ search Index Repository
class AdvQryTreeParser extends TreeParser;
options {
importVocab=AdvQryParser;
}
{ // java code ที่ customize เพิ่มเข้าไป
// มีวัตถุประสงค์หลักก็เพื่อเชื่อม object ภายนอกเข้ามา
// เพื่อให้สามารถใช้ในขณะที่กำลัง process tree ได้
static final java.util.BitSet EMPTY = new java.util.BitSet();
IndexRepository repo;

public void setIndexRepository(IndexRepository repo) {
this.repo = repo;
}

public java.util.BitSet getByLabel(String labelValue) {
return repo.getQuery().getByLabel(labelValue);
}
}
search
returns [java.util.BitSet ret = EMPTY;]
: ret = expr
;

expr
returns [java.util.BitSet ret = EMPTY;]
: ret = unaryExpr
| ret = biExpr
| ret = single
;

unaryExpr
returns [java.util.BitSet ret = EMPTY;]
:#(NEGATE ret=expr)
{ ret.flip(0, ret.length());}
;

biExpr returns [java.util.BitSet ret = EMPTY;]
{
java.util.BitSet left, right;
}
:#(AND left=expr right=expr) {left.and(right); ret = left;}
|#(OR left=expr right=expr) {left.or(right); ret = left;}
;

single
returns [java.util.BitSet ret = EMPTY;]
:label:TERM { ret = getByLabel(label.getText()); }
;

syntax ของ TreeParser จะเขียนเหมือน lexer กับ parser
คือขึ้นต้นด้วย rule name และตามด้วย Matching Syntax
วิธีการท่อง tree ของเราก็คือทุก node ที่เรา visit จะต้อง
return ผลลัพท์ออกมา ซึ่งผลลัทพ์นั้นก็มีทั้งได้จากการ search repository
หรือผลลัพท์ที่ได้จากการทำ operation AND หรือ operation OR
ประโยค
returns [java.util.BitSet ret = EMPTY;]
ก็คือการ define ว่า rule ของเราจะ return java Class อะไร
และมีค่า default เป็นอะไร
:#(AND left=expr right=expr)
หมายถึงการ matching node ที่มี root node เป็น AND และมี child node อยู่ 2 node
โดยทั้ง 2 node ต้องเป็น expr Node
:#(AND left=expr right=expr) {left.and(right); ret = left;}
กรณี่ที่ maching ได้ก็จะทำ Action ที่ระบุ ในกรณีนี้
ก็คือ call method and ของ object left(Class BitSet)
โดย pass parameter right(class BitSet) ไป
:label:TERM { ret = getByLabel(label.getText()); }
กรณีที่มี node เดียว, Matching Syntax สามารถใส่ตรงๆได้เลย
ไ่ม่ต้องมี #() ให้เกะกะ
ส่วนคำว่า label:TERM มีความหมายว่าให้สร้าง ตัวแปรชื่อ label
ใน code เพื่อที่เราจะใช้อ้างอิงใน action ได้

Integrate Lexer, Parser, TreeParser
หลังจากเรา define Lexer, Parser และ TreeParser
ก็จะต้องทำการ generate java Class ขึ้นมา
ทำโดยสั่งคำสั่ง
java antlr.Tool <inputfile>>

และในส่วน code ของการ search ก็จะเขียนดังนี้
public int[] advSearch(String searchStr) {
AdvQryLexer lexer = new AdvQryLexer(
new StringReader(searchStr));
AdvQryParser parser = new AdvQryParser(lexer);
try {
parser.search();
AdvQryTreeParser tps = new AdvQryTreeParser();
tps.setIndexRepository(repo);
BitSet bs = tps.search(parser.getAST());
return converToArray(bs);

} catch (Exception e) {
// TODO Auto-generated catch block
e.printStackTrace();
}
return null;
}


ข้อมูลอ้างอิง

Related link from Roti

Sunday, March 13, 2005

Project Log Analyzer #1

เมือวันศุกร์แวะไปบริษัทฯมา
เจอหนูจิ๋วกำลังหมกมุ่นกับ
การทำเอกสารสรุปรูปแบบการใช้งานของ user
โดยทำการสรุปจาก Application log file
ที่มีขนาดของข้อมูลประมาณ 40000 รายการ ต่อวัน

ตัวอย่างของข้อมูล
2004-10-11 09:13:07,384  ananda 1400 20.17.99.19 /wpm/uc2050.do(method=listWi..
2004-10-11 09:13:19,456 ananda 1400 20.17.99.19 /wpm/uc2050.do(method=search..
2004-10-11 09:13:21,694 ananda 1400 20.17.99.19 /wpm/uc2050.do(method=select..
2004-10-11 09:13:28,390 ananda 1400 20.17.99.19 /wpm/uc1040.do(method=gotoEn..
2004-10-11 09:16:04,091 ananda 1400 20.17.99.19 /wpm/uc1040.do(method=create..
2004-10-11 09:16:07,814 ananda 1400 20.17.99.19 /wpm/uc1040.do(method=print1..

ก็เลยคิดจะทำโปรแกรมช่วยวิเคราะห์ให้
ใช้ idea เรื่อง label จาก Taxonomie ที่คุณ bact note ไว้
ออกแบบให้มี rule ที่ทำหน้าที่ assign label
ให้กับแต่ละบรรทัดใน log file
แล้วผู้ใช้สามารถ query เลือกแสดงผลเฉพาะ
label ที่ต้องการได้

ส่วนแรกที่ต้องทำก็คือส่วน Engine ที่ใช้ในการ assign label ให้กับ log file
โดยออกแบบให้ Engine parse log file ทีละ line
จากนั้นก็ consult rule ว่าควรจะ assign label ให้หรือเปล่า
โดยแบ่ง rule เป็น 2 แบบคือ
  • พวกที่ assign label โดยดึงค่า label มาจากข้อมูลตรงๆ
  • พวกที่ assign fix label โดยดูว่าข้อมุลนั้นมี pattern ตามที่กำหนดหรือไม่
และเพื่อให้ flexible ยิ่งขึ้นก็กำหนดให้มีพวก logic
and, or ใน rule แบบที่ 2 ได้ด้วย
กำหนดให้เก็บข้อมูลการ config rule ในลักษณะ XML File

ตัวอย่าง xml file
<spec>
<tokenizer class="mx.laz.PatternTokenizer" pattern=" ,"/>

<elements>
<element id="user" mapPos="3"/>
<element id="date" mapPos="0"/>
<element id="time" mapPos="1"/>
<element id="action" mapPos="6"/>
</elements>

<labels>
<label id="user" >
<helper
class="mx.laz.helper.CopyFromElement"
elementId="user">
</helper>
</label>

<label id="action" labelValue="uc2110">
<helper
class="mx.laz.helper.PatternMatch"
elementId="action">
<pattern>.*uc2050\.do\(method=selected.*</pattern>
</helper>
</label>

<label id="test" labelValue="2050_ananda">
<helper class="mx.laz.helper.AndHelper">
<left>
<helper
class="mx.laz.helper.PatternMatch"
elementId="action">
<pattern>.*uc2050.*</pattern>
</helper>
</left>
<right>
<helper
class="mx.laz.helper.PatternMatch"
elementId="user">
<pattern>ananda</pattern>
</helper>
</right>
</helper>
</label>

<label id="test2" labelValue="2050_ananda_id">
<helper class="mx.laz.helper.AndHelper">
<left>
<helper
class="mx.laz.helper.PatternMatch"
elementId="action">
<pattern>.*uc2050.*</pattern>
</helper>
</left>
<right>
<helper class="mx.laz.helper.AndHelper">
<left>
<helper
class="mx.laz.helper.PatternMatch"
elementId="user">
<pattern>ananda</pattern>
</helper>
</left>
<right>
<helper
class="mx.laz.helper.PatternMatch"
elementId="action">
<pattern>.*id.*</pattern>
</helper>
</right>
</helper>
</right>
</helper>
</label>
</labels>
<indexRepository class="mx.laz.repository.HsqlIndexRepository"/>
</spec>
ลักษณะการทำงาน
  • Engine ทำการอ่าน log file เข้ามาทีละราย
  • tokenizer ทำการ split line ออกเป็น element
  • จากนั้นก็ทำการ assign label ให้กับ line
  • ผลการ assign label จะเก็บไว้ใน indexRepository

การ parse xml file
ปกติเราสามารถแบ่ง tool ที่ใช้ parse xml ออกเป็น 2 พวกใหญ่ๆคือ
พวกที่ 1 ต้องเขียน code เยอะหน่อย ส่วนพวกที่ 2 ก้ต้องมีการเขียน
descriptor บางอย่างที่เป็นตัวกลางระหว่าง java object
กับ xml file เช่น xml schema

Tool ที่เลือกใช้ก็คือ Common Digester
ซึ่งจัดอยู่กึ่งกลางระหว่างพวกที่ 1 กับพวกที่ 2
ที่เลือก Digester ก็เพราะยังไม่เคยใช้
ก็เลยอยากรู้่ว่ามัน powerfull แค่ไหน
Note: subproject ของ jakarta ส่วนใหญ่จะใช้
Digester เป็นตัว parse config file
เช่น Struts ใช้ digester เป็นตัว parse
action mapping file ส่วนใครที่เคยเขียน
server.xml ของ tomcat ผิดๆ คงเคยเห็น stack trace
ของ digester ที่ชวนให้งงว่าเกิดอะไรขึ้น


ตัว Digester จะใช้ SAX event + Stack ในการ parse xml file
เราจะเขียน rule เพื่อ map ให้ Digester รู้ว่าเมื่อเกิด event หนึ่งๆขึ้น
ควรจะทำอะไรดี โดยมี stack เป็นตัวช่วยเก็บข้อมูล (เก็บ temporary object)
ตัวอย่าง event ที่เกิด
  <a>         -- Matches pattern "a"
<b> -- Matches pattern "a/b"
<c/> -- Matches pattern "a/b/c"
</b>
<b> -- Matches pattern "a/b"
<c/> -- Matches pattern "a/b/c"
</b>
</a>
ตัวอย่าง code ที implement
 
Digester digest = new Digester();
digest.push(this); //push this onto stack

digest.addObjectCreate("spec/tokenizer",
"class", WhiteSpaceTokenizer.class);
digest.addSetProperties("spec/tokenizer");
digest.addSetNext("spec/tokenizer", "setTokenizer");
addObjectCreate คือ rule ที่ใช้บอกว่า
ถ้าเจอ <tokenizer> ที่อยู่ภายใต้ <spec>
ก็ให้ทำการสร้าง Object ขึ้นมาจาก Class ที่กำหนดไว้ใน
Attribute "class" ของ <tokenizer>
โดยมี default class คือ WhiteSpaceTokenizer
เมื่อสร้างเสร็จแล้วก็ให้ push object นั้นไว้ใน stack ด้วย
addSetProperties จะเป็นการ scan หา attribute
ใน current tag แล้วนำไป set ให้กับ object
ที่อยู่บนสุดของ stack
addSetNext เป็นการกำหนดว่าเมื่อจบ
tag tokenizer แล้วให้นำ object ที่อยู่บนสุดของ
stack ออกมา set ให้กับ object บน stack อันถัดไป
โดยใช้ method ชื่อ setTokenizer (ในกรณีนี้ก็ืคือ
this.setTokenizer(XXXTokenizerImpl))
  digest.addObjectCreate("spec/elements/element", 
Element.class);
digest.addSetProperties("spec/elements/element");
digest.addSetNext("spec/elements/element", "addElement");

digest.addObjectCreate("spec/labels/label", Label.class);
digest.addSetProperties("spec/labels/label");
digest.addSetNext("spec/labels/label", "addLabel");
digest.addObjectCreate("spec/labels/label/helper",
"class", DummyHelper.class);
digest.addSetProperties("spec/labels/label/helper");
digest.addBeanPropertySetter(
"spec/labels/label/helper/pattern");
digest.addSetNext("spec/labels/label/helper", "setHelper");

digest.addObjectCreate("spec/indexRepository",
"class", IndexRepository.class);
digest.addSetNext("spec/indexRepository",
"setIndexRepository");
rule addBeanPropertySet คือ rule ที่ใช้ add
ค่า Text Element ที่อยู่ระหว่าง tag pattern ให้กับ property
ที่ชื่อ pattern ของ object ที่อยู่บนสุดของ Stack

ส่วนที่ยากขึ้นมาหน่อยก็คือ ส่วน helper
ที่มีลักษณะ recursive ลงไปได้เรื่อยๆ
digester ก็มี feature ในการ map
SAX Event ในลักษณะของ patern matching เช่นเดียวกัน
  digest.addCallMethod("*/left/helper", 
"setLeft", 1, new Class[]
{AbstractHelper.class});
digest.addCallMethod("*/right/helper",
"setRight", 1, new Class[]
{AbstractHelper.class});

digest.addObjectCreate("*/left/helper", "class", DummyHelper.class);
digest.addObjectCreate("*/right/helper", "class", DummyHelper.class);

digest.addSetProperties("*/left/helper");
digest.addSetProperties("*/right/helper");
digest.addBeanPropertySetter("*/left/helper/pattern");
digest.addBeanPropertySetter("*/right/helper/pattern");

CallParamRule rule = new CallParamRule(0, true);
digest.addRule("*/left/helper", rule);
digest.addRule("*/right/helper", rule);
เครื่องหมาย * แทนการ match อะไรก็ได้
rule addCallMethodเป็นการเตรียม method
object ที่ใช้ call object ที่อยู่บนสุดของ stack
จากนั้นก็ add Method object ไว้ใน stack
rule CallParamRule เป็นการระบุให้
นำเอก object ที่อยู่บนสุดของ stack
ไป set เป็น parameter ให้กับ object
ที่อยู่บนสุดของ stack

์Note: สังเกตุว่าเราสามารถเขียน digester rule ได้
2 วิธีคือ digest.addXXX กับ digest.addRule
วิธีแรกเป็นแค่ shortcut ของวิธีที่ 2


Note: จริงแล้วเราสามารถลดรูปในส่วน left กับ right
ได้ โดยกำหนด pattern match เป็น "*/helper/*/helper"
ชึ่งสามารถแทน "*/left/helper" และ "*/right/helper"
แต่ด้วยเหตุผลกดใดไม่ทราบ digester ที่เขียนแบบนี้
จะ match SAX event ไม่เจอ


Note: กรณีที่ xml ซับซ้อนอาจจะต้องมีการ debug ดูว่า digester ทำงานตามที่เราต้องการหรือไม่
ก็ให้add log4j เข้าไปใน class path พร้อมทั้ง set log4j.properties
  log4j.rootLogger=DEBUG, 1
log4j.appender.1=org.apache.log4j.ConsoleAppender
log4j.appender.1.layout=org.apache.log4j.PatternLayout
log4j.appender.1.layout.conversionPattern=%c-%L-%p-%m%n
log4j.logger.org.apache.commons.digester=DEBUG,1


ข้อมูลเพิ่มเติม

Related link from Roti

Friday, March 11, 2005

Ruthsarian Layouts

Page Layout
เหมาะสำหรับผู้ไม่คล่อง CSS เช่นผม
สำหรับ copy ไปใช้อย่างเดียว
Ruthsarian Layouts

ใน site เดียวกันนี้มีแถม
Cryptography javascript library
Cryptonoke

แต่้ถ้าจะดูเป็นเรื่องเป็นราว ก็ต้องอันนี้
http://pajhome.org.uk/crypt/md5/

Related link from Roti

อ่านเอาเพลิน 2

Peeking Into Google: "e president of operations and vice president of engineering, offered a rare behind-the-scenes tour of Google's architecture on Wednesday. Hoelzle spoke here at EclipseCon 2005, a conference on the ope"

Related link from Roti

Ha ha. What 's this ?

search เจอโดยบังเอิญ
Idea เขาร้ายเหมือนกันครับ
จับ blog เราเข้าตลาดหุ้นเสียแล้ว

BlogShares - pok 's blogger

ใครมี blog ก็ลองเปลี่ยน blog parameter ดูนะครับ
"http://blogshares.com:81/blogs.php?blog=http://pphetra.blogspot.com%2F"

Related link from Roti

อ่านเพลินๆ

Greg Duffy [dot] com - Google's Cookie and Hacking Google Print

Related link from Roti

Wednesday, March 09, 2005

ทดลอง Jboss-TreeCache

ใครที่เคยเขียน Web Application ที่ Scale ใหญ่หน่อย
คงจะรู้ว่าการ implement Application Cache นั้นจะช่วย
ให้ชีวิตยืนยาวขึ้นเล็กน้อย (ไม่เครียดกับปัญหา server ตอบสนองช้า)

ปกติผมจะใช้ OSCache
ซึ่งเท่าที่ใช้มาก็ ok ดี (ยกเว้นว่ามีปัญหา
อยู่ที่จุดการ implement monitor ที่จะใช้จับ
statistic การใช้ cache)

แต่มี opensource cache อยู่ตัวหนึ่งที่ผมสนใจอยากรู้
นั่นก็คือ Jboss TreeCache
สิ่งที่แตกต่างออกไปใน jboss-treecache ก็คือ
1. เป็น cache ที่มีลักณณะเป็น tree
cache โดยทั่วไปจะมีลักษณะเป็น HashTable คือ มี key แล้วก็ value
การเข้าถึง cache จะใช้คำสั่ง

put (Object key, Object value)
get (Object key)


ส่วน jboss-treeCache จะใช้คำสั่งในลักษณะ

put (String treePath, Object key, Object value)

get (String treePath, Object key)


ดูๆ ก็เหมือนไม่มีอะไรพิเศษ เพราะจริงๆแล้ว
เราสามารถตั้งชื่อ key ให้มีลักษณะกลุ่ม tree ได้เหมือนกัน
เช่น
put ("erp.po.Order." + order.getId(), order)
เมื่อเทียบกับ
put ("/erp/po/Order", order.getId(), order);
ก็ไม่ได้ให้ความรู้สึกแตกต่างกัันมากนัก

แต่ความแตกต่างๆจริงๆ จะไปอยู่ที่การ implement aspect
intercept ใน Jboss-treeCacheAOP
ซึ่งขอยกยอดคำอธิบายไปอยู่ข้างท้ายสุด

2. support Transaction scope
การแก้ไขข้อมูลใน cache ร่วมอยู่ใน transaction ด้วย
ถ้า rollback , ก็จะเกิด undo ใน cache ด้วย

ตัว Jboss-treeCache แยก package ออกเป็น 2 ส่วนหลัำกๆคือ
  • treeCache
  • treeCacheAOP (extend จาก treeCache)
ตัวที่น่าสนใจก็คือ ตัว AOP
เนื่องจาก concept ของการ cache ที่เราสามารถเลือก
option ให้ทำการ slide Object ที่ put ลงไปออกเป็น
node ย่อยๆ เช่นสมมติเรามี

class Person
private Long id;
private String name;
private Address addr;

class Address
private String line1;
private String line2;


ถ้าเรา Config ให้ Class Person ให้เป็น aop-enabled
แล้วเราสั่ง put Person Object ลงใน cache
ตัว treeCache จะทำการแยกส่วน object ออกเป็น
node ย่อยๆ (แทนที่จะเก็บ object Person ลงไปตรงๆ)
มีลักษณะเป็น tree ตามนี้

+Node Person
-Node id
-Node name
+Node addr
Node line1
Node line2

ที่นี้ข้อดีของการทำอย่างนี้คืออะไร
ในกรณีที่ Environment ที่เป็น Cluster
ถ้าเราสั่ง

person.getAddr().setLine1("bah");

ถ้าเป็น cache ทั่วๆไป ก็จะต้องมีการ replicate
object Persion ทั้งก้อนออกไป
แต่ถ้าเป็น treeCacheAOP จะมีการ replicate
ออกไปเฉพาะส่วน line1 เท่านั้น (ทำเฉพาะ node ที่เปลี่ยนแปลง)
ซึ่งถ้าเป็นเช่นนี้ traffic ของการ replicate ก็จะมีขนาดเล็ก
ทำให้ไม่เกิดปัญหา bottleneck
หรือ lag ที่เกิดจากการ serialize object ขนาดใหญ่

เท่าที่ลอง set server ขึ้นมา 2 server
เพื่อทดสอบ treeCache (แบบไม่ใช่ AOP)
replication feature ดู
ก็ไ่ม่พบความยุ่งยากอะไร ใช้ตรงๆดังนี้

ตอน initialize

tree = new TreeCache();
tree.setClusterName("test");
tree.setCacheMode(TreeCache.REPL_ASYNC); // replicate แบบ Async
tree.startService();

มันจะ set ค่า default ของ JGroup ให้เอง
เวลาใช้ก็แค่

getTreeCache().put("pok", getKey(), getValue());


ข้อเสียอีกอย่างของ treeCache ก็คือ
ถ้าเราใช้นอก server jboss
dependency ของ library มันจะเป็นหางว่าวเลย
ต้องเพิ่ม jar ลงไปไม่น้อยกว่า 8 ตัว

ข้อมูลเพิ่มเติม
  • TreeCache
  • TreeCacheAOP
  • ส่วนใครที่คิดจะใช้ ให้ดู todo ให้ดีเสียก่อน มี bug ร้ายแรงอยู่ตัว

Related link from Roti

Tuesday, March 08, 2005

TrimPath javascript component

มี javascript ที่น่าสนใจอยู่ 3 ตัว
  • spreadsheet component เป็น spreadsheet ที่เขียนด้วย javascript และ run บน browser
  • TrimQuery เป็น sql parser ที่ช่วยให้เรา select ข้อมูลที่อยู่ใน structure array ได้
  • Javascript Template เป็น template engine ที่ฝังอยู่ใน web page ได้
http://trimpath.com/project

ตัวที่น่าสนใจมากก็คือ template engine
โดยเฉพาะถ้านำไปใช้กับ xmlrpc

Related link from Roti

SWF -> Web App Framework

ตอนนี้มี Web Applicaion Framework อยู่เต็มไปหมดแล้ว
แต่ตัวนี้น่าสนใจตรงที่มี feature IPU (inplace page update)
ใครที่สนใจตัดต่อไปใช้กับ framework อื่นๆลองเข้าไปดูได้
SWF Overview
SWF How to use Region (ว่าด้วยเรื่อง IPU)

Related link from Roti

หมกมุ่นกับ thumb drive bootable

ช่วงนี้กำลังลง linux Ubuntu บนเครื่อง Notebook ของตัวเอง
ด้วยความที่ไม่เคยจัด partition มาก่อน
ก็เลยต้องงัดเอา partition magic มาใช้
เหลือบไปเห็น menu "rescue disk"
ก็เลยคิดอยากมีบ้าง แต่บนเครื่อง notebook
ดันไม่มี floppy disk (จริงๆก็มีนะ แต่พังไปแล้ว)
ก็เลยอยากให้มันอยู่บน ThumbDrive แทน
โดยให้เครื่องสามารถ boot ได้ด้วย thumbdrive

หาบทความเกี่ยงกับเรื่องนี้อ่าน
ได้ความตรงกันว่า
ถ้า bios support ก็ boot ได็ไม่มีปัญหาอะไร
เพียงแต่หาทางเขียน boot record ลงบน thumb drive
โดยเขาบอกว่า ให้เรา format dirve floppy disk ก่อน(แบบ boot ได้)
จากนั้นก็ใช้ Tool mkbt copy boot record จาก
floppy ไปลง thumb drive
ฟังดูง่ายดี แต่เครื่องเราดันไม่มี floppy
ก็เลยต้องเสาะหา floppy image
ไปเจอบนแผ่น partition magic มี
rescue disk floppy image อยู่
ก็เลยใช้ mkbt จัดการ copy เสีย
ที่นี้ก็เกิดปัญหาอีกว่า เราจะจัดการเอา content
ต่างๆที่อยู่ใน floppy image ไปลง
บน thumb drive ได้อย่างไร
ไปได้ tool VFD ที่เป็น software ทำ Virtual Floppy Driver
สามารถ mount floppy image เข้าเป็น drive
บน window ได้

สุดท้ายพอลอง boot ดูก็เงียบ boot ไม่ได้
เกิดความสงสัยว่าอะไรที่ผิด
ก็เลยเปลี่ยนจาก mkbt มาใช้
Hp Drive key format utility (url นี้แปลกๆ เข้าได้บ้างไม่ได้บ้าง มีการ redirect อุตลุดเลย
ถ้าเข้าไม่ได้ให้ลอง search หา SP27213.exe ดู)

ซึ่งสามารถใช้กับ thumb drive ยี่ห้ออื่นๆได้
tool นี้ช่วยให้เรา format thumb drive โดยเลือก option
ิให้ boot ได้ แต่ tool นี้ใช้กับ rescue disk ของ partition magic ไม่ได้
มันฟ้องว่า system file ไม่ครบ (คิดว่ามันคงมองหา kernal.sys
ซึ่งใน boot image ของ partition magic ไม่มี)

ก็เลยหาไปหา freedos มาลองทดสอบดู
พบว่า boot ได้ แต่เสียใจด้วยมันไม่ support ntfs

ลองเอา MS-Dos7.10 มาลองบ้าง
เห็นว่า support ntfs ด้วย
ปรากฎว่า boot ได้แต่มี error จำนวนหนึ่ง
ก็เลยหยุดดีกว่า ชักเกินเลยแล้ว

สรุปใช้ rescue CD ดีที่สุด

Related link from Roti

สรุป Trip จักรยาน

ตอนนี้พวกพี่สมชายกลับมาเรียบร้อยแล้ว
เริ่มสรุป Trip กันแล้ว ดูได้ที่นี่
สรุปทริป..ปั่นจักรยานซำเหมา เลาะริมแม่น้ำโขง เลียบชายแดน ไทย-ลาว จาก นครพนม-น่าน 12-26 ก.พ.48

Related link from Roti

Sunday, March 06, 2005

ทำความรู้จัก org.apache.commons.modeler Component

ตัว Common Modeler ก็คือ component
ที่ออกแบบมาให้เราสามารถ implement JMX MBean
ได้ง่ายขึ้น(โดยเฉพาะส่วน metadata ซื่งเป็นส่วนที่น่าเบื่อ)

ย้อนอธิบายหลักการของ JMX สักนิดหนึ่ง
Architecture ของ JMX แบ่งเป็น 4 ส่วน
  1. Management Application นี่คือส่วนที่ user ใช้งาน
  2. Distributed Layer เป็นช่องทางการสื่อสารระหว่าง Agent layer กับ Management App. โดยเลือก config ได้หลากหลาย protocol
  3. Agent Layer คือ MBean Server ประกอบด้วย service 4 อย่าง คือ Timer, monitoring, dynamic loading, relationship services.
  4. MBean คือ Class ที่ห่อ Resource ที่ต้องการจัดการไว้ และเปิดช่องทางในการจัดการกัย Resource นั้นๆ
Note: ใครที่เคยใช้หรือได้ยิน Product ตระกูล Tivoli ของ IBM
ตัว Tivoli ก็คือ JMX implementation ของ IBM


Mbean สามารถ implement ได้ 2 แบบหลักคือ
  • Static
  • Dynamic
โดยในส่วน Dynamic มีส่วนขยายเพิ่มเติมอีก 2 แบบคือ
  • ModelMBean
  • OpenMBean
static mbean บังคับให้เราต้อง define interface ให้ชัดเจน
ส่วน Dynamic นั้นยืดหยุ่นกว่า มี interface กลางๆแบบเดียว
(รูปแบบคล้ายๆ Reflection)แล้วเรา implement interface นั้น

ส่วน ModelMBean นั้น Extend จาก Dynamic MBeanแต่เพิ่ม
feature ต่างๆ มีความยืดหยุ่นมากกว่า ส่วนที่ชัดเจนในแง่ implement
ก็คือ ในส่วน ModelMBean นั้น provide class มาให้แล้ว
เราเพียงแต่ plug ส่วน operation หรือ Attribute
ของเราเข้าไปโดยผ่านทาง Method ที่กำหนด (setModelBeanInfo)
กรณี OpenMBean นั้น extend จาก Dynamic เช่นกัน เพียงแต่
มีข้อกำหนดว่า Attribute ทั้งหลายจะมี DataType อยู่ในกลุ่มที่
Spec. กำหนดเท่านั้น (พวก Simple Datatype)

สำหรับ common modeler นั้น base อยู่บน ModelMBean
โดยมีวัตถุประสงค์ให้เราสร้าง MBean ได้ง่ายขึ้น


การใช้งานเบื้องต้น
  • การ define MBean จะทำผ่านทาง XML file
mbean-descriptor.xml
  • ตัว MBean Class นั้นให้ extend BaseModelMBean โดย implement operation เป็น method ธรรมดา
  public class GroupMBean extends BaseModelMBean {
public void addRole(Role role){
}
}
  • การ register mbean จะทำผ่าน Class Registry
   URL url= this.getClass().getResource
("/com/mycompany/mypackage/mbeans-descriptors.xml");
Registry registry = Registry.getRegistry();
registry.loadMetadata(url);

ข้อมูลเพิ่มเติม
JMX Introduction
http://www-128.ibm.com/developerworks/java/library/j-jmx1/
เอกสารสำหรับ Common Modeler จะมีอยู่ใน JavaDoc เท่านั้น
http://jakarta.apache.org/commons/modeler/apidocs/index.html

Related link from Roti

Saturday, March 05, 2005

Web Form โดยไม่ใช้ Table tag

เจอ blog นี้

http://www.themaninblue.com/writing/perspective/2004/03/24/

อยากทำ form โดยไม่ใช้ table tag มานานแล้ว
พอแยก Semantic ออกจาก presentation แล้ว code
clean ขึ้นเยอะ


Related link from Roti

Azureus Stat Component

ช่วงนี้ใช้ Azureus ซึ่งเป็นโปรแกรม Bittorent ตัวหนึ่ง
ชอบใจตรงหน้าจอ Statistic ที่แสดงผลเป็น graph หน้าตาสวยงาม
เนื่องจากช่วงนี้พัฒนา Eclipse plugin อยู่ ก็เลยสนใจ UI ของคนอื่น
ที่พัฒนาด้วย SWT หรือ JFace


azureus stat view Posted by Hello

เกิดความสงสัยว่า เขาใช้ opensource library ในการทำ graph
หรือเปล่า ถ้าใช่จะได้เอาไปใช้บ้าง ก็เลยเข้าไปดู source code
ปรากฎว่าเขา implement เอง ไม่ได้ใช้ library ของใคร
เท่าที่ดูก็ออกแบบ clean ดี
แบ่ง package เป็นส่วน View กับ Component
ตัว View จะ delegate ให้ component ทำหน้าที่ render
ในที่นี้ก็คือ
ActivityView delegate ให้ SpeedGraphic รับหน้าที่ render


Class Diagram Posted by Hello

Note ไว้กันลืม เพื่อ project ไหนต้องการ monitor tool จะได้
มีตัวอย่างไว้ Assign

Related link from Roti

Thursday, March 03, 2005

ทดลองใช้ JGAP

อ่านเจอมานานแล้ว พึ่งได้ฤกษ์ทดลองใช้
JGAP เป็น genetic algorithms component

ไปได้ยินโจทย์่ว่า
เดิมในฐานข้อมูลลูกค้า อนุญาติให้ลูกค้าเลือก bank
ได้มากกว่า 1 bank ปัจจุบันต้องการเปลี่ยนให้ลูกค้า
ใช้ได้เพียง bank เดียวเท่านั้น
ปัจจุบันมีลูกค้าประมาณ 400000 ราย
มีจำนวน bank อยู่ 6 bank
ต้องการให้ computer ทำการเลือกธนาคารให้ลูกค้า
โดยให้แต่ละธนาคารได้จำนวนลูกค้าไปเท่าๆกัน

หลังจากได้ยินโจทย์ก็เกิด idea อยากลองใช้ JGAP solve

Step 1.
เริ่มแรกสุดที่ต้องทำการก็ออกแบบ Chromosome ว่า
จะประกอบด้วย Gene อะไรบ้าง
ลองกำหนดให้ Gene หนึ่งๆ คือ รูปแบบการเลือกธนาคาร

bank-> A B C D E F
รูปแบบที่ 1 1 0 0 0 0 0
รูปแบบที่ 2 0 1 0 0 0 0
....
รูปแบบที่ 64 1 1 1 1 1 1

ดังนั้นใน 1 chromosome จะมี gene ยังสิ้น 64 gene
จากนั้นก็เขียนโปรแกรมให้อ่านข้อมูล Raw Data
ทำการนับจำนวนคน โดย group ตาม pattern
ตัวอย่างการนับที่ได้
010011=>6370 (มีคนที่เลือกธนาคาร B, E, F ทั้งหมด 6370 คน)
ค่า 6370 จะเป็น constrain ของ Gene นั้น
ที่จะสามารถ distribute จำนวนคนไปยัง bank B หรือ E หรือ F
รวมแล้วไม่เกิน 6370 คน

ข้อมูลใน gene 1 gene ประกอบด้วย
  • constrain (ข้อมูลนี้ fix ไ่ม่เปลี่ยนไปในแต่ละรุ่น)
    • pattern การเลือก bank
    • จำนวนคนทั้งหมดที่เลือก bank ตาม pattern นี้
  • data (ข้อมูลนี้จะเปลี่ยนไปเรื่อยๆ เมื่อ evolution ไปยังรุ่นต่อไป)
    • ข้อมูลจำนวนคนที่แต่ละ bank ได้รับ
Step 2.
implement random method ของ Gene
ในตอนเริ่มต้น chromosome แต่ละ chromosome
จะถูกสร้างโดยการ random ขึ้นมา
ดังนั้นต้อง implement method นี้ให้ gene แต่ละ gene
ทำง่ายๆโดยใช้วิธี random ไปเลยว่าแต่ละธนาคารจะได้รับแจกคนไปเท่าไร

Step 3.
implement Mutation mehod ของ Gene
ทำง่ายๆโดย สุ่มโอนคนระหว่าง ธนาคารภายใน Gene นั้นๆ

Step 4.
ออกแบบ Fitness Fuction โดยถ้า chromosome ไหนได้แต้มสูง
chromosome นั้นก็มีโอกาสอยู่รอดสืบลูกสืบหลานได้
ทำง่ายๆ โดย จำนวนคนที่แต่ละธนาคารได้ ต้องไกล้เคียงกับ
400000/6 (จำนวนคนทั้งหมด/จำนวนธนาคาร)
ยิ่ง chromosome ไหนเข้าไกล้ค่าอุดมคติก็ยิ่งได้ค่าสูง

ในการ Run
สิ่งที่ต้องกำหนดก็คือ จำนวน Population ที่ใช้
จำนวนครั้งของการ evolution ที่เกิด
เลือกใช้ Population -> 500
evolution -> 10 รุ่น
ได้ผลลัพท์ดังนี้

ธนาคาร A ได้คนไปทั้งสิ้น 64162,
ธนาคาร B ได้คนไปทั้งสิ้น 65580,
ธนาคาร C ได้คนไปทั้งสิ้น 66109,
ธนาคาร D ได้คนไปทั้งสิ้น 63307,
ธนาคาร E ได้คนไปทั้งสิ้น 66026,
ธนาคาร F ได้คนไปทั้งสิ้น 68684,

เวลาในการ run = 7370 ms

ตัวอย่าง ผลลัพท์การ distribute
pattern จำนวนรวม A B C D E F
-------------------------------------------------------
111010=>6311 1337,1116,1913,0,1945,0,
001100=>6393 0,0,1161,5232,0,0,
010000=>6125 0,6125,0,0,0,0,
100100=>6422 1396,0,0,5026,0,0,
000011=>6398 0,0,0,0,82,6316,


สรุป
ผลลัพท์ที่ได้ยังไ่ม่น่าพอใจนัก
คงจะเป็นผลจากการออกแบบ fitness function ,
mutation method
ที่ยังไม่ค่อยดีนัก
่
ทดลองเปลี่ยนค่า จำนวน evolution
พบความประหลาดใจว่า จำนวนรุ่นยิ่งสูง
ผลลัพท์ยิ่งผิดผลาดมากขึ้น
สงสัยเราออกแบบ fitness function ผิดแน่ๆเลย

ไว้ถ้ามีโอกาสได้ data จริง ก็จะลอง
run ดูกับ data จริงดูว่าจะได้ผลลัพท์เป็นอย่างไร
(คิดว่ารูปแบบการเลือกธนาคารใน data จริง
จะมีลักษณะเฉพาะมากกว่า data test ที่เกิด
จากการ random)

Related link from Roti

Monday, February 28, 2005

Continuous Testing - PAG

Eclipse Plugin ที่น่าใช้อีกตัว
Continuous Testing - PAG
ไว้จะลองทดสอบดู

Related link from Roti

GeoPhrase - Get a GeoPhrase on your page

วันนี้เจอ Blog อันหนึ่งส่งข้อความทักทาย
"Ary you from Bangkok"
ก็เลยสงสัยว่าเขา integrate logic เข้าไปใน blogger อย่างไร
ดูใน html ก็พบ tag

Are you from

ที่แท้เป็นบริการของ
GeoPhrase - Get a GeoPhrase on your page
แต่เขาบอกว่าบริการนี้จะมี ad ด้วย
ก็คือ 1 ใน 50 ครั้งจะเกิดการ open ad
แต่ก็จำกัดว่า ip หนึ่งจะเกิด Ad ได้ไม่เกิน 1 ครั้งต่อ 1 วัน

รู้สึกว่า Service เล็กๆน้อยๆเหล่านี้มีเยอะขึ้นทุกวัน

Related link from Roti

CSDL - Software Tools and Services - Jupiter

Eclipse Plugin ที่น่าสนใจ
CSDL - Software Tools and Services - Jupiter

Related link from Roti

Sunday, February 27, 2005

อยากขี่จักรยาน !!!

วันนี้ออกไปปั่นจักรยานเล่น (ฝากลูกให้แม่เด็กเลี้ยง)
วนไปทาง ม.เกษตร
ค่อยรู้สึกหายอยากหน่อย
เดิมทีมีนัดขี่จักรยานกับพี่ๆปีละ 1 ครั้ง
เป็น trip ขี่รอบประเทศไทย
(ทำมาได้ 2 ปีแล้ว ปีแรกขี่จากกรุงเทพ ไป อุบล
ปีที่ 2 อุบลไปนครพนม)
ปีนี้เริ่มต้นที่นครพนม เลาะลำโขงขึ้นไปต่อ
ติดว่ามีลูกอ่อน
หวังว่าปีหน้าแม่เด็กจะลาพักร้อนมาเลี้ยงลูกแทน
http://www.thaimtb.com/cgi-bin/viewkatoo.pl?id=45141

Related link from Roti