Tuesday, December 13, 2005

เรื่องทางสาธารณะสุขบ้าง

PracticallyKM
อันนี้อ่านเจอใน GotoKnow
เป็นเรื่องที่คุณหมอ phichet เล่าถึงประสบการณ์การดูงาน
ที่ออสเตรเลีย น่าสนใจทีเดียว

อ่านไปอ่านมาก็เจอที่คุณหมอพูดถึง
นพ.สุภัทร ฮาสุวรรณกิจ
จำชื่อได้ว่า เป็นเพื่อนร่วมกิจกรรม (สมัยเรียน)
ก็เลยตามไปดูใน google
ได้บทความที่เขาเขียนมาจำนวนหนึ่ง
เลยเอามาลง link ไว้


อ่านแล้วก็รู้สึกว่าเราชักจะหมกมุ่นกับ โลกของ technical มากเกินไปแล้ว

Related link from Roti

Monday, December 12, 2005

Javascript in ruby style

นึกแล้วว่า Prototype มันต้องมีอะไรดีๆซ่อนอยู่
ด้วยความที่ว่ามันไม่มีเอกสารให้ดู
เราก็เลยไม่รู้ว่ามันทำอะไรได้บ้าง

วันนี้อ่านเจอ article เรื่อง Prototype Meets Ruby: A Look at Enumerable, Array and Hash
อ่านแล้วต้องร้อง "ว้าว" ดังๆ

Related link from Roti

ทดลองใช้ OpenLaszlo

ผมเคยทดลอง evaluate OpenLaszlo ตั้งแต่สมัยที่มันยังไม่มี คำว่า open นำหน้า
จากการทดลองเล่น ยอมรับเลยว่าติดใจใน interface ที่ดู หรูหรา มาก
แต่ตอนนั้นมีปัญหาว่า compile-time มันสูงมาก
อีกอย่าง swf file ที่ได้ก็มีขนาดใหญ่เกินไป (1 MB นิดๆ)

วันก่อนเจอที่ mk เขียนถึง OpenLaszlo ก็เกิดอาการสนใจอยากลองเล่นอีกครั้ง

เริ่มแรกทดสอบขนาดก่อนเลย
เอาที่ helloworld ก่อนเลย เพราะมันเป็น app ที่เล็กที่สุดที่เป็นไปได้แล้ว

<canvas>
<text>Hello Laszlo!</text>
</canvas>

ขนาดที่ได้ ก็คือ 102,599 Byte
ลองมาดูว่า ตัวเลข 100 กว่า KB นี้มันแถมอะไรมาให้บ้าง
(openlaszlo มี feature ที่ช่วย describe ว่า
app ของเราหลังจาก compile แล้วจะมีอะไรแปะอยู่ข้างในบ้าง)
ใน hello app ของเรา จะแบ่งออกเป็น 2 ส่วนคือ
LFC (laszlo foundation class) กับ Instances
โดย LFC ของ flash version 7 มีขนาดก่อน zip 209 KB
ส่วน instance ของเรามีขนาด 168 Byte
หลังจาก zip แล้วจะได้ขนาด 69 KB
ซึ่งไม่เท่ากับ swf file ที่เราได้กลับมา
แสดงว่ามี overhead ในการแปลงเป็น swf อีก 30 KB
(ตรงนี้ไม่รู้เหมือนกันว่า ขนาด 30 KB นี้
เป็น fix size หรือ variable size
เมื่อโปรแกรมใหญ่ขึ้น)

สรุปขนาดของ App
เล็กสุด ก็น่าจะประมาณ 100 KB

ที่นี่ด้านเวลาบ้าง
เวลาใน version นี้คงไม่เป็นปัญหาแล้ว
เพราะเราสามารถ pre-compile เป็น format lzo ได้
(จริงๆแล้ว binary ข้างในคือ swf format)

ที่นี้ลองมาดู factor สุดท้ายบ้าง
ก็คือเรื่องของ runtime environment
(พัฒนาเสร็จแล้ว จะเอาไปใช้แล้ว)
กรณี static web app
อันนี้หมายถึง file laszlo ของเราไม่ได้ dynamic เปลี่ยนแปลงไปมา
(หมายถึงโปรแกรมนะ ไม่ใช่ data)
การเอาไปใช้ วิธีที่ง่ายที่สุด ก็คือ copy file lzo (ที่ได้จากการ pre-compile)
ไปไว้ใน web application ที่เราต้องการ
โดยแค่เปลี่ยนนามสกุลเป็น swf ก็ใช้ได้แล้ว

ส่วนกรณีที่ lzx (โปรแกรม) ของเราเปลี่ยนไปมาได้ (dynamic)
อันนี้ไม่ขอแนะนำ เพราะ compile time
สูงมาก (>15 sec)

Related link from Roti

Wednesday, December 07, 2005

Switch to Postgresql

อ่านเจอเรื่อง FeedLounge Now running on PostgreSQL
เขาพูดถึงประเด็นว่าทำไมเขาถึง switch จาก MySQL -> PostgreSQL
แรกเริ่มเดิมทีเขาใช้ MySQL 's MyISAM table แต่ต่อมาก็เปลี่ยนไปใช้
mysql 's InnoDB table แทน โดยเขาพบปัญหาจาก
table locking behavior in MyISAM
เนื่องจากลักษณะงานของเขามี write ครึ่งหนึ่งของ read
(read 4 ล้าน quries/day, write 2 ล้าน queries/day)
ผลก็คือทำให้ scalable ของเขาต่ำมาก (< 10 users)

ผลลัพท์จากการใช้ InnoDB เขาบอกว่า
พบปัญหา slow performance
จากการ load Data (ไม่ใช่เรื่อง query)
ก็เลยตัดสินใจเปลี่ยนอีกที
คร่าวนี้ย้ายไป PostgresSQL แทน

เหตุผลที่เป็นแรงจูงใจในการเปลี่ยนคราวนี้ ก็มี
  • Database Size
    เมื่อตอนเปลี่ยนจาก MyISAM -> InnoDB database
    ที่เคยมีขนาด 1 GB ก็กลายเป็น 10+GB
    ปัจจุบัน ณ ขณะที่เปลี่ยน ขนาดได้กลายเป็น 34 GB
    หลังจากย้ายลง Postgres แล้ว ขนาดเหลือเพียง 9 GB
  • Load time
    การ load data ลง database
    เดิม MySQL ใช้เวลา 1 วัน ในการ load
    เมื่อเปลี่ยนมาใช้ PostgreSQL ก็เหลือแค่ 4 ชั่วโมง


นอกจากนี้ยังพบว่า Postgres ใช้ memory
แค่ 1/3 ของ mysql

ที่น่าสนใจก็คือ comment ที่มีคนมา post
เช่น
  • InnoDB ใน MySQL 5 มี feature "compact" row format
    ที่ช่วยลดขนาด table ได้
  • Postgres ไม่สามารถ set ให้ใช้ share buffer
    ได้เต็มที่เหมือน MySQL แต่ Postgers สามารถใช้ประโยชน์จาก
    OS cache ได้, และมีค่า effective_cache_size ที่ใช้ set
    เพื่อให้ optimizer รับรู้
  • Feedlounge ใช้ GUID เป็น primarykey
    คนของ MySQL ก็เลยบอก
    GUIDs tend not to do well for index storage efficiency, since InnoDB stores the uncompressed primary key in all secondary index records.

    ผลก็คือเขาต้องใช้ IO เยอะขึ้นไปอีก (จากการ load index)
  • UUID is really poor choice for primary key for Innodb.
    The data is going to be clustered by it… and it is random which means you will insert in radom spots in giant BTREE (as it holds rows). Furthermore inserts in the middle will frequently result in page spits which causes IO and fragmentation.

Related link from Roti

Monday, December 05, 2005

Samorost


samorost เป็นชื่อ game ที่เขียนโดย
Jakub Dvorský
art มากๆ

Related link from Roti

Constraint Programming

เขียนเรื่อง ruby, rails เยอะแล้ว กลับมาที่ java บ้าง

วันก่อนผมอ่านเจอเรื่อง Solving Sudokus in Java
คนที่ยังไม่รู้จัก sudokus ให้ลองดูคำอธิบายได้ที่ wikipedia on sudokus
(อธิบายละเอียดยิบเลยครับ)
ที่สนใจก็คือ ผมยังไม่เคยได้ยินคำว่า Constraint Programming มาก่อน
ใน tutorial ข้างบนเขาใช้ library ที่ชื่อ Koalog Constraint Solver
ซึ่งเป็น commercial product
ผมก็เลยลอง search หา Library ที่เป็น opensource license ดู
เจอเจ้า Cream: Class Library for Constraint Programming in Java
ผลผลิตจาก Japan (ดีที่ web site เขาเป็นภาษาอังกฤษ)

ลองดูวิธีการใช้ Cream solve Sudokus กัน
(เอกสารของ cream มีไม่เยอะ แต่โชคดีที่เขามีตัวอย่างให้ดู
รวมทั้งมีตัวอย่าง sudokus ด้วย ก็เลยแกะมาเล่าให้ฟังได้)
โดยเราจะใช้โจทย์เดียวกับ tutorial ที่อ้างถึงข้างบน
เริ่มด้วยการ define problem array ก่อน
static int prob[][] = {
{6,0,0,0,5,8,4,9,0},
{0,2,4,0,0,0,0,0,0},
{0,0,0,0,2,0,0,3,6},
{0,0,0,0,0,0,9,0,7},
{7,0,0,3,0,0,8,0,0},
{1,5,0,0,8,9,0,0,0},
{0,3,1,0,0,0,0,0,0},
{0,0,0,0,3,0,5,0,0},
{0,0,8,0,9,5,0,0,0}
};


ก่อนที่จะ solve ก็ต้องมีการสร้างตัวแปรให้ cream รับรู้ก่อน
ในกรณีของเรา ก็คือ เราจะมีตัวแปรทั้งหมด 9 * 9 = 81 ตัว
โดยตัวแปรทั้งหมดจะต้องถูกสร้างภายใต้ context network
Network net = new Network();

IntVariable v[][] = new IntVariable[9][9];
for (int i = 0; i < 9; i++) {
for (int j = 0; j < 9; j++) {
if (prob[i][j] == 0) {
v[i][j] = new IntVariable(net, 1, 9);
} else {
v[i][j] = new IntVariable(net, prob[i][j]);
}
}
}

จะเห็นว่าถ้าค่าใน prob array เป็น 0 เราจะ new variable
ด้วย constructor new IntVariable(net, 1, 9)
ความหมายก็คือ ค่าใน variable นี้ เป็นไปได้ตั้งแต่ 1 ถึง 9
ส่วนกรณีที่มีค่าอยู่แล้ว ก็จะใช้ constructor new IntVariable(net, x)
โดย x ก็คือค่าของ variable นั้นๆเลย

ขั้นถัดไปก็คือการ declare constraint ของปัญหา
เริ่มด้วย
  • แต่ละ row ห้ามมีเลขซ้ำกัน
    // แต่ละ row ห้ามมีเลขซ้ำกัน
    IntVariable tmps[] = new IntVariable[9];
    for (int i = 0; i < 9; i++) {
    for (int j = 0; j < 9; j++) {
    tmps[j] = v[i][j];
    }
    new NotEquals(net, tmps);
    }


  • แต่ละแถวห้ามมีเลขซ้ำกัน
    // แต่ละ column ห้ามซ้ำกัน
    for (int j = 0; j < 9; j++) {
    for (int i = 0; i < 9; i++) {
    tmps[i] = v[i][j];
    }
    new NotEquals(net, tmps);
    }


  • ในแต่ละ box 3 * 3 ห้ามมีตัวเลขซ้ำกัน
    // ในแต่ละ box 3x3 ห้ามมีตัวเลขซ้ำกัน
    for (int bi = 0; bi < 3; bi++) {
    for (int bj =0; bj < 3; bj++) {
    int cnt = 0;
    for (int i = 0; i < 3; i++) {
    for (int j = 0; j < 3; j++) {
    tmps[cnt++] = v[i+(bi*3)][j+(bj*3)];
    }
    }
    new NotEquals(net, tmps);
    }
    }


จะเห็นว่า constraint ข้างบนใช้ constructor NotEquals(net, array_of_variable)
สร้างขึ้นมา
ความหมายก็คือ ในตัวแปรที่ผ่านเข้าไปทั้งหมดนั้น ห้ามมีตัวใดตัวหนึ่งซ้ำกันเลย

พอเสร็จจากขั้นการ declare constraint ก็เป็นขั้นการ solve แล้ว
Solver solver = new DefaultSolver(net);
Solution sol = solver.findFirst();

for (int i = 0; i < 9; i++) {
for (int j = 0; j < 9; j++) {
System.out.print(sol.getIntValue(v[i][j]));
if (j < 8) {
System.out.print(",");
}
}
System.out.println();
}

โดยในการ call เราสามารถเลือก call โดยกำหนด timeout ได้ด้วย
จากการจับเวลาเครื่องผม
กรณีใช้ findFirst จะใช้เวลาประมาณ 76-80 ms
ส่วนกรณี findBest จะใช้เวลาประมาณ 90-100 ms

คนที่สนใจ Constraint Programming ลองเข้าไปดูที่นี่ครับ

Related link from Roti

Rails Migrations

เคยเขียนเรื่อง Migration ของ RoR ไปทีหนึ่ง
ในเรื่อง ทดลอง acts_as_tree feature ของ ActiveRecord (Ruby on Rails)
วันนี้เห็น link tutorial ที่เข้าใจง่ายดี
ก็เลยเอามาลงให้ดูกัน
The Joy of Migrations

ประโยคคำสั่งที่เราสามารถใช้ใน Migration class ก็มี
  • create_table
    syntax ของ create_table ก็คือ
    create_table :test do |t|
    t.column :col0, :string
    t.column :col1, :text
    t.column :col2, :integer
    t.column :col3, :float
    t.column :col4, :datetime
    t.column :col5, :timestamp
    t.column :col6, :time
    t.column :col7, :date
    t.column :col8, :binary
    t.column :col9, :boolean
    t.column :col10, :int2
    end

    ตั้งแต่ col0 -> col9 เป็น datatype ที่ ActiveRecord define ไว้แล้ว
    ซึ่งมันจะทำการแปลงเป็น datatype จริงๆให้อีกที
    โดยขึ้นอยู่กับ Database ที่เราเลือกใช้
    ส่วนกรณี col10 เป็น datatype ที่ ActiveRecord ไม่ได้ define ไว้
    เวลา generate sql ActiveRecord ก็จะ generate ออกไปตามที่เราพิมพ์เลย

    sql ที่ได้จากข้างบน จะหน้าตาดังนี้
     CREATE TABLE test ("id" serial primary key,
    "col0" character varying(255),
    "col1" text,
    "col2" integer,
    "col3" float,
    "col4" timestamp,
    "col5" timestamp,
    "col6" time,
    "col7" date,
    "col8" bytea,
    "col9" boolean,
    "col10" bigint)


    กรณีที่เป็น varchar เราสามารถกำหนด length ได้แบบนี้
      t.column :name, :string, :limit=>25


    กรณีที่ต้องการกำหนด null, default ก็เขียนดังนี้
      t.column :col11, :string, :limit=>25, :default=>"blank", :null=>false

    ซึ่งจะได้ออกมาดังนี้
     "col11" character varying(25) DEFAULT 'blank' NOT NULL)


    รายละเอียดปลีกย่อยของ create_table ยังมีอีกจำนวนหนึ่ง
    ให้ลองดูใน RDoc ของ activeRecord ดู
  • drop_table
    อันนี้ชัดเจน ใช้ drop table
  • add_column
    format ของ add_column เหมือนตอนที่เราเขียน t.column
  • remove_column
    อันนี้ชัดเจน ไม่ต้องอธิบาย
  • rename_table
  • rename_column
  • change_column
    เปลี่ยน definition ของ column
  • change_column_default
  • add_index
    ตัวอย่าง
    add_index(:accounts, [:branch_id, :party_id], :unique => true)

  • remove_index

Related link from Roti

Sunday, December 04, 2005

MySQL Compatiblility Functions

อ่านเจอจาก Robby on Rails
ใน pgFoundry มี project MySQL Compatiblility
A reimplemenation of as many MySQL functions as possible in PostgreSQL, as an aid to porting.

ใน release ล่าสุดมี function แบ่งออกเป็น 8 กลุ่มคือ
  • aggregate
  • bit
  • controlflow
  • datetime
  • information
  • mathematical
  • operators
  • string


สำหรับคนที่ไม่ต้องยุ่งกับการ port mysql -> postgres
ก็สามารถ load มาศึกษาว่า
user define function บน postgres เขียนอย่างไร?

Related link from Roti

Wednesday, November 30, 2005

คำถามดีๆ

คราวก่อนที่ post เรื่อง Higher Order Procedure ไป
bact ได้ post ถามว่า
method(op) กับ : ใน oper[:+]

นี่คือทำให้เราพิมพ์ + กับ - ได้ใช่มั๊ยครับ ?
คือ + กับ - เป็น object ด้วย

เป็นคำถามที่ดีจริงๆ
ผมชักชอบ blog มากขึ้นแล้วหล่ะ
คำถามใน blog ทำให้ความรู้เราเพิ่มขึ้น
(เพราะมันช่วยชี้ให้เห็นว่า เราลืมมองอะไรไปบ้างหรือเปล่า)
อย่างคราวก่อนที่ mk ถามเรื่อง "?" ที่อยู่หลัง ruby method
นั่นก็เป็นคำถามที่ดีเหมือนกัน
เพราะสมัยนั้นที่ผมมอง ruby code ผมไม่เคยตั้งคำถามเรื่องนั้นเลย
คำถามนั้นทำให้เราเห็นจุดอ่อนของเรา

กลับมาที่คำถามของ bact
ตอนแรกผมก็มองเหมือน bact (อาศัยความเคยชินจาก scheme)
+ มันต้องเป็น object ประเภท procedure แน่เลย
แต่กลายเป็นไม่ใช่
ลองดู code ต่อไปนี้
อันนี้ จาก scheme48

pphetra@[~]: scheme48
Welcome to Scheme 48 1.1 (made by pphetra on Sun Nov 13 15:03:12 ICT 2005).
Copyright (c) 1993-2004 by Richard Kelsey and Jonathan Rees.
Please report bugs to scheme-48-bugs@martigny.ai.mit.edu.
Type ,? (comma question-mark) for help.
> +
#{Procedure 52 +}
>

อันนี้ชัด + ใน scheme คือ procedure

ต่อไปจาก ruby บ้าง

pphetra@[~]: irb
irb(main):001:0> :+.class
=> Symbol
irb(main):002:0> 1.method(:+).class
=> Method
irb(main):003:0> 1.method(:+).call(2)
=> 3
irb(main):004:0> 1.method("+").class
=> Method
irb(main):005:0> 1.method("+").call(2)
=> 3
irb(main):006:0>

อา :+ จริงๆแล้วคือ symbol
ใน ruby, Object ทุกตัวจะมี method ที่ชื่อ method
คำสั่ง 1.method(:+) return ค่า
ออกมาเป็น method + ของ object 1
ซึ่งเราสามารถใช้ method call เพื่อสั่ง run จรีิงๆ
ปกติ method method จะรับ symbol เป็น parameter
แต่ก็สามารถส่งค่าเป็น String ให้ก็ได้เหมือนกัน

คำถามถัดไป ก็คือ แล้ว symbol คืออะไร
อืมม์ ยังไม่ค่อยแจ่มเหมือนกัน
แต่ดูตัวอย่างนี้ก่อน

pphetra@[~]: irb
irb(main):001:0> f1 = :pok
=> :pok
irb(main):002:0> f2 = :pok
=> :pok
irb(main):003:0> f1.object_id
=> 3918094
irb(main):004:0> f2.object_id
=> 3918094

เห็นในคำอธิบายเขาบอกว่า symbol จะมี instance เดียว
เสมอ ไม่ว่าจะอ้างถึงกี่ครั้งก็ตาม
หรือ ไม่ว่าจะอ้างจากคนละ context ก็ตาม

pphetra@[~]: irb
irb(main):001:0> module A
irb(main):002:1> $f1 = :pok
irb(main):003:1> end
=> :pok
irb(main):004:0> module B
irb(main):005:1> module C
irb(main):006:2> $f2 = :pok
irb(main):007:2> end
irb(main):008:1> end
=> :pok
irb(main):009:0> $f1.object_id
=> 3920142
irb(main):010:0> $f2.object_id
=> 3920142

Related link from Roti

Tuesday, November 29, 2005

Run JettyLaucher in Ðebug Mode

ช่วงหลังๆนี่ผมเปลี่ยนมาใช้ JettyLaucher แทน Tomcat Plugin
เพราะดูมัน lightweight ดี
แต่มีที่ติดใจอยู่ก็คือ กรณีที่เราแก้ java file
เราจะต้องสั่ง restart web app ใหม่ทุกครั้ง

วันนี้อ่านเจอ Tip ง่ายๆ
ที่ทำให้เราไม่ต้อง restart web app ทุกครั้งที่แก้ java file
เส้นผมบังภูเขาแท้ๆ
ให้ start jetty ใน debug mode แทน
เพราะ eclipse ใน debug mode
มันจะทำ hot replace class file ให้เราโดยอัตโนมัติ

Related link from Roti

Monday, November 28, 2005

Python Lambda & Ruby Block

เห็น mk เขียนเล่าเรื่องเรียนรู้ Ruby แล้ว
มีประเด็นที่สะกิดใจอยู่นิดหนึ่งตรง
เรื่อง iterator ที่ mk ยังคาใจอยู่

ที่สะกิดใจ ก็คือ เกิดความสงสัยว่า python
ก็น่าจะมี concept คล้ายๆแบบนี้เหมือนกัน
ก็เลยลองเปิดหนังสือดู
ก็พบในบทว่าด้วยเรื่อง lambda & filter
ลองดูตัวอย่างนี้

เริ่มที่ ruby ก่อน
ary = [1, 2, 3, 4] 
result = ary.select { |x| x % 2 == 0 }
result # => [2, 4]


ถ้าเขียนแบบเดียวกันใน python
ary = [1, 2, 3, 4]
result = filter(lambda x: x%2 == 0, ary)
print result # => [2, 4]


โจทย์เดียวกัน
ลองเขียน ruby block อีกแบบดู
ary = [1, 2, 3, 4]
prc = lambda {|x| x%2 == 0}
result = ary.select(&prc)
result # => [2, 4]

Note: สังเกตุเครื่องหมาย & หน้า ตัวแปร prc
เป็นการบอกว่า pass ค่า block นะ ไม่ใช่ argument

น่าจะพอสรุปได้ว่า ruby block กับ
python lambda เป็นเรื่อง concept เดียวกัน
เพียงแต่ ruby ปรับปรุง syntax ให้สามารถ
pass block (lambda) ได้ง่ายกว่า

Note: แฟนผมเดินเข้ามาแอบอ่าน post นี้
ดูสักพัก แล้วก็เดินส่ายหัวจากไปพร้อมกับเสียงงืมงัม python ruby ruby python ...
(ช่วงนี้ผมเขียน post บ่อย แกกลัวว่าจะแอบ chat
กับสาวๆ)

Related link from Roti

ETL

ETL => extract, transform and load
CloverEtl

Related link from Roti

Higher Order Procedures

วันนี้เจอ ruby code ที่เขียนแบบนี้
oper = proc do |op|
proc do |x, y|
x.method(op).call(y)
end
end

add = oper[:+]
add[1,2] # => 3

sub = oper[:-]
sub[2,1] # => 1


นี่ถ้าเป็นเมื่อก่อน ตอนที่ยังไม่เรียน scheme
ก็คง งงงวย พักใหญ่
(การเขียน คง กับ งงงวย ติดกัน อาจทำให้ผู้อ่านเกิด
อาการเมา blog ได้)
แต่หลังจากเรียนรู้ scheme แล้วก็เลยรู้ว่า
มันคือ higher order procedure นี่เอง


• A procedure is said to be “first-order” if
none of its arguments is itself a procedure.
• A procedure is said to be “higher-order” if
one or more of its arguments is a procedure.


ถ้าเขียนใน scheme ก็จะเป็นแบบนี้
(define oper
(lambda (op)
(lambda (x y)
(op x y))))

(define add
(oper +))

(define sub
(oper -))

(add 1 2) ;; => 3
(sub 2 1) ;; => 1

Related link from Roti

Sunday, November 27, 2005

Enhance xmp (example printer)

อ่านเจอใน http://eigenclass.org/
Mauricio Fernandez. เขาเขียน utilities เล็กๆ
ที่ชื่อ Enhance xmp
เพื่อใช้ evaluate ตัวอย่าง code และแสดงค่า ณ ตำแหน่งต่างๆในโปรแกรม

ยกตัวอย่าง
สมมติเรามี snippet code ดังนี้
person1 = "Tim"
person2 = person1.dup
person1[0] = "J"
person1
person2


ถ้าเราต้องการแสดงให้เห็นว่า variable person1 และ person2
มีค่าเป็นอะไร เราก็มักจะเขียน comment ลงไปแบบนี้
person1 # => "Jim"
person2 # => "Tim"


ปกติเวลาเราเขียน comment แบบนี้
ก็มักจะใช้วิธี manual, ก็คือเปิด editor ออกมาใส่ค่าลงไปเอง

utilities ที่ Mauricio เขียน จะช่วย fill-in ค่าพวกนี้ให้เราโดยอัติโนมัติ
โดยเราเพียงแต่เขียนแบบนี้
person1 = "Tim"
person2 = person1.dup
person1[0] = "J"
person1 # =>
person2 # =>

เมื่อ run ผ่านโปรแกรม xmp
xmp ก็จะใส่ค่าลงไปให้เราเอง

ที่นี้ลองมาใล่ดูว่า source code เขาทำงานอย่างไร
technique ที่เขาใช้ก็คือ
เขาจะอ่าน source code ขึ้นมาก่อน
จากนั้นก็แทรก code ไปตัดต่อโปรแกรมบรรทัดที่ต้องการ
โดยสร้างตัวแปรขึ้นมารับผลลัพท์ที่ได้จาก evaluate บรรทัดนั้น
จากนั้นก็ให้พิมพ์ผลลัพท์ออกมาทาง stderr io
code = ARGF.read
idx = 0
newcode = code.gsub(/^(.*) # =>.*/) do |l|
expr = $1
(/^\s*#/ =~ l) ? l :
%!((#{VAR} = (#{expr}); $stderr.puts("#{MARKER}[#{idx+=1}] => " + #{VAR}.inspe
ct) || #{VAR}))!
end

จะเห็นว่าเขาอ่านโปรแกรมขึ้นมา แล้วใช้ gsub
ในการหาบรรทัดที่มี pattern ที่มี # =>
ถ้าเจอบรรทัดนั้น ก็จะทำการแทรก code เพิ่มเข้าไป
ลักษณะของ code ที่ได้ออกมาในตัวแปร newcode จะมีหน้าตาแบบนี้
person1 = "Tim"
person2 = person1.dup
person1[0] = "J"
((_xmp_1133097178_956604 = (person1); $stderr.puts("!XMP1133097178_657069![1] =>
" + _xmp_1133097178_956604.inspect) || _xmp_1133097178_956604))
((_xmp_1133097178_956604 = (person2); $stderr.puts("!XMP1133097178_657069![2] =>
" + _xmp_1133097178_956604.inspect) || _xmp_1133097178_956604))

จะเห็นได้ว่ามีการสร้างตัวแปรมารับ
แล้วก็พิมพ์ตัวแปรนั้นออกมาในรูปของ xxx[idx]=>value

พอแก้ code ไดดังนี้ เขาก็ทำการเรียกใช้งาน code ดังนี้
stdin, stdout, stderr = Open3::popen3("ruby", "-w")
stdin.puts newcode
stdin.close
output = stderr.readlines

เขาใช้ standard library open3 เข้ามาช่วย
(พวกที่ใช้ win32 จะไม่มี library ตัวนี้ให้)
โดยการเรียกโปรแกรม ruby ในอีก subprocess หนึ่ง
โดย subprocess จะรับข้อมูลผ่านทาง stdin
และให้ output กลับมาผ่านทาง stdout, stderr
ในกรณี xmp นี้ ก็จะใช้ข้อมูลจาก stderr เป็นหลัก

ตัวอย่าง stderr ที่ได้จาก program ข้างบน
!XMP1133102283_175558![1] => "Jim"
!XMP1133102283_175558![2] => "Tim"


ขั้นต่อไปก็เป็นการแปลความผลลัพท์ที่ได้จาก stderr
XMPRE = Regexp.new("^" + Regexp.escape(MARKER) + '\[([0-9]+)\] => (.*)')
results = Hash.new{|h,k| h[k] = []}
output.grep(XMPRE).each do |line|
result_id, result = XMPRE.match(line).captures
results[result_id.to_i] << result
end

จะเห็นว่ามีการ new Hash โดยใช้ block
(ที่เคยเขียนไปใน post เรื่อง Cache with Ruby Hash)
ถ้ามีการ access hash เมื่อไร ก็ให้สร้าง empty array เตรียมไว้ให้เลย
จะเห็นว่าใน code ก็จะ grep หาบรรทัดที่มีผลลัพท์
แล้วก็ทำการ put ผลลัพท์ลงไปใน hash (<< คือการ add ลง array)
ที่ต้องใช้ array มาเก็บ ก็เพราะบรรทัดที่อยู่ใน loop
มันจะถูก evaluate ได้หลายครั้ง
เช่น
i = 0
4.times {
i+=1 # => 1, 2, 3, 4
}

จะเห็นว่าบรรทัดใน loop มันจะมีค่าได้หลายค่า

ขั้นถัดไปก็ง่ายแล้ว ก็แค่ อ่าน code ขึ้นมาใหม่
จากนั้นก็ทำการ append ผลลัพท์ที่ได้ลงไป
ส่วนที่เหลือ ก็เป็นกรณี warning กับกรณี error แล้ว
ก็ใช้ technique แบบเดียวกัน เพียงแต่ง่ายกว่า
ตรง pattern ของ warning มันจะมีเลขบรรทัด
บอกมาเสร็จ ก็แค่แทรกลงไปให้ถูกบรรทัด
ส่วนกรณี error ถ้ามีก็ให้ต่อท้าย output ได้เลย

การได้ไล่โปรแกรมอย่างนี้ เป็นการเรียนรู้ที่ดีมาก
ผมว่าการจะเขียนโปรแกรมได้ดีนั้น ส่วนหนึ่งก็คือ
ต้องอ่าน source code คนอื่นเยอะๆ

Related link from Roti

Trip พายเรือ #2

ต่อจาก Trip พายเรือ #1


13/12/2540
วันนี้เจอฝายเพิ่มอีก 3 ฝาย แต่คราวนี้ยุ่งยากขึ้น
เพราะไม่สามารถทำคนเดียวได้
ต้องมีการไหว้วาน และมีค่าตอบแทนให้
(สมัยนั้นเรือแคนนูแบบเบาๆยังไม่เข้ามาในไทย)

2 ฝายแรกความสูงยังไม่มากนัก
ยังใช้วิธีค่อยๆคลายเชือกปล่อยเรือลงไปทีละนิด
และให้มีคนคอยรับเรือด้านล่าง
(ตรงด้านล่างจะมีแท่งคอนกรีตขวางน้ำอยู่
ถ้าปล่อยให้ลอยลงไปตรงๆ ก็จะชนและรั่วได้)
จบจาก 2 ฝายแรก เรือก็ได้รูเล็กๆ เพิ่มมา 1 รู
ส่วนฝายที่ 3 เป็นเขื่อนคอนกรีตขนาดใหญ่
ต้องใช้วิธียกเรือขึ้นเดินแบกไปปล่อยท้ายเขื่อนเอา

ทิวทัศน์วันนี้ บ้านคนเริ่มบางตาแล้ว
แต่ก็ยังมีถนนเลียบไปกับแม่น้ำตลอดทางอยู่

ที่พักของคืนนี้ ทำเพิงนอนที่หาดทรายริมหมู่บ้าน
เช่นเคย ต้องมีการขออนุญาติผู้ใหญ่บ้านก่อน
บ้านนี้ยุ่งขึ้นหน่อย ต้องแสดงบัตรประชาชนให้ดูด้วย

Related link from Roti

Thursday, November 24, 2005

OSCache อีกที

คราวก่อนพูดถึงเรื่อง การ implement cache บน Web Application
ที่ใช้ OSCache เข้ามาช่วย
วันนี้อ่านเจอใน Raible Design เรื่อง Clustering OSCache
เลยรู้ว่าตัวเองเข้าใจผิดในส่วน feature Cluster ไป

ลองอ่านนี่ดู
Caches across a cluster only broadcast messages when flush events
occur. This means that the content of the caches are built up
independently on each server, but whenever content becomes stale on
one server it is made stale on them all. This provides a very high
performing solution since we never have to pass cached objects around
the cluster. And since there is no central server that is in charge of
the cluster, the clustering is very robust


เดิมผมก็เข้าใจว่ามันทำ replicate cache
ระหว่าง node
แต่กลายเป็นว่า มันส่ง event broadcast
เฉพาะกรณีที่เราสั่ง flush (expire) content ใน cache

Related link from Roti

Wednesday, November 23, 2005

DrScheme

ช่วงนี้ผมกำลังเรียนรู้ Lisp อยู่
แต่เผอิญไปเจอ online course
Structure and Interpretation of Computer Programs
ของ MIT เข้า

course นี้เข้าใช้ scheme (ซึ่งเป็น dialect ของ Lisp)
ก็เลยเปลี่ยนมาเรียนรู้ scheme ก่อน

ตอนแรกที่เรียน ก็ใช้ scheme48 เป็น interpreter
run ใน text mode
ซึ่งก็ใช้ได้ดีแหล่ะ
แต่วันนี้ทดลอง load PLT Scheme มาลองเล่นดู
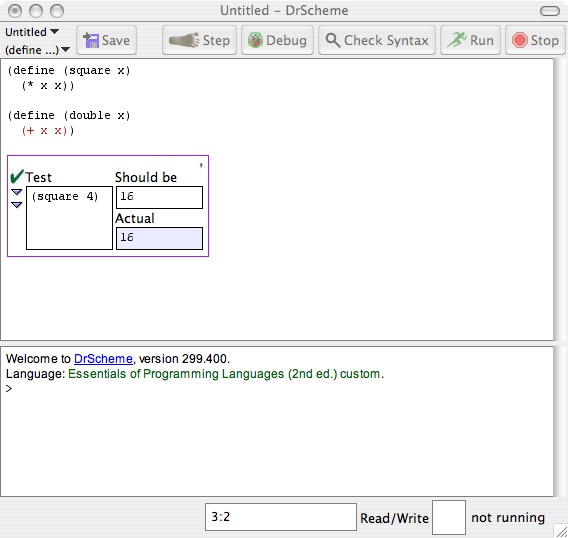
ได้เรื่องเลย มันออกแบบมาสำหรับการเรียนรู้ scheme
ทำให้มี feature ที่น่าสนใจหลายอย่าง

ลองดูในภาพนี้


หน้าต่างครึ่งบนเป็นส่วน file ที่เรา edit
ส่วนครึ่งล่างเป็น REPL ที่ทำให้เราทดลอง evaluate expression ได้

จะเห็นว่าเราสามารถใส่ test case
เข้าไปในส่วน editor ของเราได้
นอกจากนี้ จะเห็นว่าในส่วน function double
จะมีบรรทัดที่เป็นสีแดงอยู่
ส่วนที่เป็นสีแดง ก็คือ บริเวณที่ PLT chekc ว่า
code นี้ยังไม่ได้ถูกเรียกใช้งานเลย (code coverage feature)

นอกจากนี้ยังมี features อื่นๆอีกเพียบเลย
ดูได้จาก A Brief Tour of DrScheme version 299.200

Related link from Roti

Israeli Wall

เมื่อเดือนก่อนได้ดูสารคดี Border ทางช่อง National GeoGraphy
เลยได้รู้ว่า อิสราเอล กำลังสร้างกำแพงแบ่งแยกที่อยู่ระหว่าง palestine
กับ Israel

ดูภาพได้ที่นี่ Apartheid Wall Gallery
Adam เขาบรรยายด้วยว่า ระหว่างการสร้างกำแพง
Palestinian buildings are destroyed but Palestinian olive groves are treated with more respect by the Israelis, who recognise the value of these important resources. Olive trees serve communities for generation after generation. They live for four or five hundred years. So, rather than grub them up with bulldozers, the Israelis dig them up carefully and then move them to Israeli land!

Related link from Roti

การ implement cache ใน Web Application #1

Post นี้จะว่าด้วย solution สำหรับ java application ก่อน
ครั้งต่อไปถึงจะว่าด้วย caching บน RoR (ruby on rails)
Tool ที่ผมเลือกใช้สำหรับ solution นี้ ก็คือ OSCache

OSCache มาพร้อมกับวิธีการใช้ 3 แบบใหญ่ๆคือ
  • ใช้ API ตรงๆ
    อันนี้เหมาะกับ implement caching ในฝั่ง business logic
  • ใช้ JSP Taglib
    อันนี้เหมาะสำหรับ fine-grain cache
    เพราะเราสามารถกำหนดบริเวณที่เราต้องการ cache ได้ตามใจชอบ
    (เลือกเฉพาะบางส่วนใน jsp ได้)
  • ใช้ CacheFilter
    อันนี้เหมาะสำหรับ cache ระดับ Page
    (เพราะว่าสะดวกในการ config ดี)


ขั้นแรกในการใช้ OSCache ก็คือ
การกำหนด Configuration ที่เราต้องการ
  • เลือกกำหนดขนาดของ cache ที่เราต้องการก่อน
    ค่า default จะอยู่ที่ 1000 objects
    (สามารถกำหนดเป็น unlimit ก็ได้)
  • ประเด็นที่ตามมาก็คือ algorithm ในการควบคุมขนาดของ cache
    OSCache มีให้เลือก 2 แบบ
    • LRU (Least-Recently-Used)
    • FIFO

    ประเด็นที่น่าสนใจอันหนึ่งของ LRU
    ก็คือ OSCache implement LRU โดยใช้
    java.util.LinkedHashMap
    ซึ่งถ้าเราตามไปดู javadoc ของ LinkedHashMap จะเห็นคำอธิบายดังนี้
    A special constructor is provided to create a linked hash map whose order of iteration is the order in which its entries were last accessed, from least-recently accessed to most-recently (access-order). This kind of map is well-suited to building LRU caches.

    และถ้าตามไปดู source code ของ OSCache ในส่วน
    LRU ก็จะพบว่า วิธีการที่มัน implement LRU จะทำเป็น 3 step
    ก็คือ
    • ทดลองดูว่าใน classpath มี LinkedHashMap หรือไม่
      ถ้ามีก็ใช้ตัวนี้
    • ถ้าไม่มี ก็จะมองหา org.apache.commons.collections.SequencedHashMap
      ของ jakarta-commons collection แทน
    • ถ้าไม่พบ ก็จะลงเอยด้วยการใช้ LinkedList
      ซึ่งอันนี้อาจจะมีผลเสียต่อ performance แทนในกรณี load สูงๆ

  • เลือกว่าจะทำ Persistent ของ cache ด้วยหรือไม่
    โดย default แรกสุด จะเก็บ cache ใน Memory เท่านั้น
    แต่เราสามารถเลือก persistent ลง Disk ได้ด้วย
    โดย option ที่น่าสนใจก็คือ
    cache.persistence.overflow.only
    ถ้าเรา set ค่านี้เป็น True เวลาที่ Memory Cache เราเต็ม
    entry ที่ถูก remove ออก จะย้ายมาลง Disk แทน
  • กำหนด cache.blocking
    default คือ false นั่นคือ กรณีที่ entry ของเราหมดอายุ
    แล้วมี thread 2 thread เข้ามาพร้อมๆกัน thread แรก
    จะเป็นผู้ได้รับเลือกให้เป็นคนที่ update ค่านั้น ส่วน thread ที่ 2
    จะได้ค่า ณ ขณะนั้น (stale entry) กลับไปแทน
    (ซึ่งก็ถือว่าใช้ได้นะ เพราะถือว่า entry มีอายุเกินกว่าที่เรากำหนดไปไม่กี่ millisec)
    แต่ถ้ากำหนดเป็น true ก็จะมีผลว่า thread ที่ 2
    จะถูก block เพื่อรอให้ thread 1 ทำการ update ให้เสร็จก่อน
    Note: เท่าที่ลองใล่ debug ดู พบว่า
    กรณีที่เป็น new Entry ใหม่ๆเลย ไม่ว่าเราจะเลือก block เป็น true หรือ
    เป็น false ก็ตาม
    OSCache จะเลือกใช้วิธี blocking สำหรับพวก new Entry เสมอ


ตัวอย่าง source code ให้ลองดูที่ document ของ OScache โดยตรง
เพราะเขาเขียนไว้ดีแล้ว

feature ที่น่าสนใจอื่นๆก็คือ
  • การกำหนด cron expression
    ที่ทำให้เรากำหนด schedule ของการ expire ได้
    เช่นกำหนดให้ cache expire ทุกเช้าวันจันทร์
  • การกำหนด group ของ cache
    อันนี้เหมาะสำหรับกำหนดกลุ่ม cache ที่มี content depend ถึงกัน
    เวลาเรามีการ update content จะได้สั่ง flush cache ทีเดียวทั้ง group ได้เลย
  • ใน jsp taglib หรือ cacheFilter สามารถกำหนด
    scope ของ cache ได้
    เช่นถ้าเป็น session, cache ก็จะถูกแยกเป็นของใครของมันเลย
    ไม่ share กัน
    แต่ถ้าเป็น application ก็จะมี cache แค่ instance เดียว
    ให้ทุก session share ใช้กัน


เพิ่มเติม
ประเด็นที่ต้อง design ดีๆ เวลาใช้ cache
ก็คือ กรณีที่ table ใน database เรามีการเปลี่ยนแปลง
แล้วเราต้องการ flush cache (delete cache) ที่เกี่ยวข้องทิ้งทั้งหมด
เราจะทำได้อย่างไร
ทางออกก็อาจจะเช่น design ให้ key ที่มี content เกี่ยวข้องกัน มี prefix เหมือนๆกัน
(เวลาสั่ง flush สามารถสั่ง flush พวกที่มี prefix ตามที่กำหนดได้)
หรือเลือกใช้ group feature เข้ามาช่วย

Related link from Roti

Sunday, November 20, 2005

JS/UIX

JS/UIX คือ Unix ที่เขียนโดยใช้ javascript อย่างเดียว
สามารถ run บน browser ได้เลย

ลองเล่น vi บนนั้นแล้ว เนียนดีมาก
แต่เจอปัญหา cursor มันอยู่ตำแหน่งแปลกๆบ้าง เป็นบางครั้ง

ใน shell มีคำสั่งที่เป็น non-standard command
อยู่หลายตัวเช่น
  • browse เป็นคำสั่งให้เปิด browser window ใหม่ และ navigate ไป url ที่ระบุ
  • fexport export data ที่อยู่ใน home directory ของเรา
  • invaders เล่นเกมส์ space invaders

ถ้าสงสัยว่ามี command อะไรให้ใช้บ้าง
ให้ใช้คำสั่ง help ดูครับ

Related link from Roti